« Alexandre, comment ChatGPT Search, Perplexity, Gemini et Claude choisissent-ils leurs sources ? »
Aucun de ces moteurs ne publie sa formule de sélection. Leurs documentations décrivent surtout l’accès : un robot de recherche à autoriser chez OpenAI, Perplexity et Anthropic, une page indexée avec extrait chez Google. Ensuite, chaque moteur reformule la question, classe des passages et cite ce qui répond le mieux.
Mis à jour le 16 octobre 2026
Mis à jour le 16 octobre 2026
Ça commence souvent pareil. Une cliente m’écrit : « J’ai posé ma question à ChatGPT. Il cite trois sites. Pas le mien. Pourquoi ? »
Bonne question. Et la réponse honnête est un peu vexante : personne ne le sait vraiment.
Je suis Alexandre Montenon, consultant marketing digital freelance à Lyon depuis 2011, plus de 150 clients accompagnés. Alors j’ai fait ce que je fais d’habitude : j’ai lu les documentations officielles d’OpenAI, de Perplexity, de Google et d’Anthropic, pour mon métier de freelance GEO.
Je sépare ce qu’elles affirment de ce qu’elles taisent. Un petit outil vous attend juste après la première partie, pour savoir si ces moteurs peuvent au moins lire votre site.
Comment ChatGPT Search choisit-il ses sources ?
ChatGPT Search lance une recherche quand votre question gagne à s’appuyer sur des informations récentes, puis il la reformule en une ou plusieurs requêtes ciblées. D’après le centre d’aide d’OpenAI, il classe ensuite les résultats avec plusieurs facteurs censés aider à trouver des informations pertinentes et fiables.
Lesquels, ces facteurs ? Mystère.
OpenAI ne publie ni la liste ni le poids de chacun. Et la place n’est pas garantie, c’est écrit noir sur blanc.

Et l’index derrière tout ça ? OpenAI écrit que ChatGPT Search s’associe parfois à d’autres fournisseurs de recherche. Son lancement s’appuie sur des fournisseurs tiers et sur des contenus fournis directement par ses partenaires.
Aucune de ces phrases ne nomme un fournisseur unique. Je ne vous raconterai donc pas quel index se cache derrière chaque réponse (ceux qui l’affirment sans source, je m’en méfie).
Passons à l’accès. OAI-SearchBot est le robot d’OpenAI dédié à la recherche.
Pour qu’un site soit éligible, il faut l’autoriser dans le robots.txt et vérifier que l’hébergeur ou le CDN laisse passer ses adresses IP publiées.
GPTBot, lui, concerne l’entraînement. ChatGPT-User intervient sur action d’un utilisateur, avec des règles robots.txt qui peuvent ne pas s’appliquer.
Ma page sur les crawlers IA et le robots.txt détaille la configuration.
Un détail m’a fait sourire. Un site qui bloque OAI-SearchBot peut quand même apparaître avec son seul lien et son titre dans ChatGPT Atlas. Cela arrive si OpenAI reçoit l’URL d’un fournisseur tiers ou la trouve en explorant d’autres pages.
La FAQ éditeurs d’OpenAI recommande la balise noindex pour l’éviter, à condition que le robot puisse lire la page.
Sur l’index derrière ChatGPT Search, je ne raconterai rien sans source. OpenAI écrit que ChatGPT Search s’associe parfois à d’autres fournisseurs de recherche : aucune phrase ne nomme un fournisseur unique.
Votre site est-il prêt pour la recherche IA ?
Petit quiz, trois questions, trente secondes. Répondez avec ce que vous savez de votre site aujourd’hui (« aucune idée » est une réponse tout à fait valable).
Votre site est-il prêt pour la recherche IA ?
Comment Perplexity sélectionne-t-il ses sources ?
Perplexity s’appuie sur un index et une infrastructure de recherche qu’il décrit lui-même, puis classe des passages de pages avant de les citer. C’est le moteur le plus bavard sur sa mécanique.
Dans son article d’architecture, l’entreprise explique qu’elle interroge son index de façon lexicale et sémantique, puis fusionne les résultats.
Des étapes de préfiltrage retirent le contenu manifestement hors sujet ou périmé. Des modèles de reclassement affinent ensuite l’ensemble final.
Le classement se fait au niveau du document et au niveau du passage, découpé en segments autonomes. Retenez-le bien : chaque passage est jugé seul.
Le centre d’aide résume le parcours en trois temps : interpréter la question, chercher des sources en ligne, puis synthétiser avec des citations numérotées vers les sources d’origine.
Conséquence pratique : chaque phrase importante doit pouvoir se lire seule, comme un extrait.
Autre curiosité, les labels. Perplexity ajoute parfois Government, Academic ou Trusted sur une source citée.
D’après sa page sur les labels, il qualifie le domaine entier, quelle que soit la page citée. Sa revue regarde entre autres si le site corrige ses erreurs, signe ses contenus et sépare l’information de la publicité et de l’opinion.
Partenariats et paiements n’influencent pas ce label. Et l’absence de label ? Elle ne signale pas un site de mauvaise qualité.
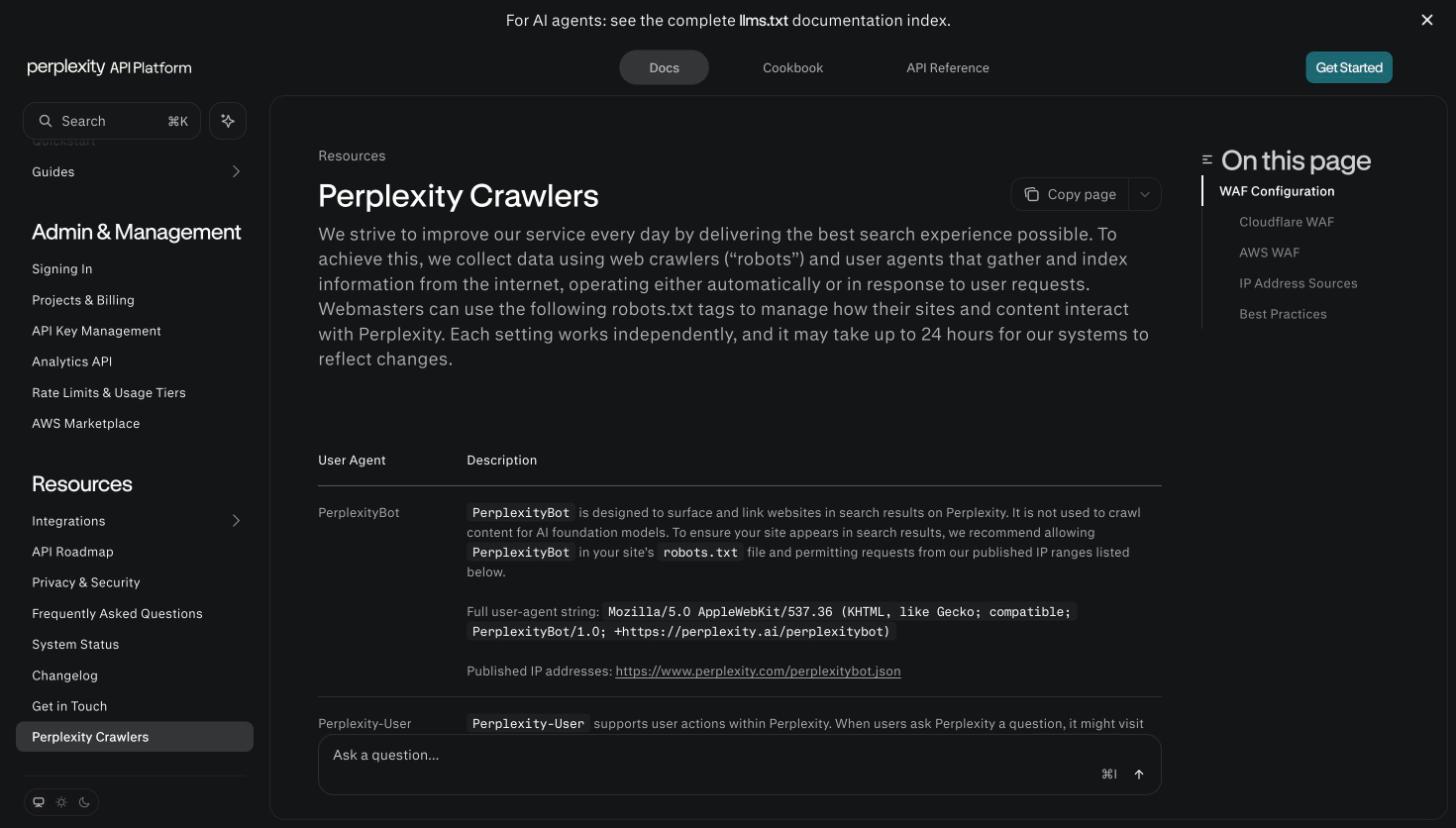
Côté robots, PerplexityBot sert à faire apparaître et à lier les sites dans les résultats, sans collecter pour l’entraînement de modèles.
Perplexity-User consulte une page à la demande d’un utilisateur et ignore généralement le robots.txt. Une modification de votre fichier peut mettre jusqu’à 24 heures à être prise en compte.
Perplexity explique dans son article d’architecture qu’il classe au niveau du document et du passage, découpé en segments autonomes. Chaque passage est jugé seul : chaque phrase importante doit donc pouvoir se lire comme un extrait.
Comment Google choisit-il les liens d’AI Overviews et d’AI Mode ?
Google applique un critère simple. Pour apparaître comme lien d’appui dans AI Overviews ou AI Mode, une page doit être indexée et éligible à un extrait dans Google Search.
La documentation Search Central précise qu’aucune exigence technique supplémentaire n’existe. Respecter les règles ne garantit rien.
Les deux fonctionnalités utilisent le « query fan-out ». Elles lancent plusieurs recherches liées sur des sous-thèmes, puis repèrent d’autres pages pendant la rédaction de la réponse.
Résultat, l’ensemble de liens est plus large et plus varié qu’une recherche classique. Pour les différences entre les deux, j’ai écrit sur AI Overviews et AI Mode.
Et Gemini ? Je m’attendais à un robot dédié. Eh bien non.
La page des robots de Google décrit Google-Extended comme un jeton robots.txt, sans user agent propre.
Il règle l’usage des contenus pour entraîner Gemini et pour l’ancrage des Gemini Apps, c’est-à-dire l’apport de contenus issus de l’index de recherche Google au moment de la requête.
Il n’affecte ni l’inclusion ni le classement dans Google Search.
Je n’ai trouvé aucune page officielle qui détaille, lien par lien, la sélection des sources de l’application Gemini. Je m’arrête donc là.
Pour AI Overviews et AI Mode, vos pages comptent dans le trafic Search Console habituel, sous le type de recherche Web. Le socle reste donc un bon référencement naturel.
Pour AI Overviews et AI Mode, le critère est simple : une page indexée et éligible à un extrait. Aucune exigence technique supplémentaire, et respecter les règles ne garantit rien.
Comment Claude choisit-il ses sources ?
Claude décide lui-même quand chercher sur le web, puis cite ses sources. Anthropic, en revanche, ne nomme pas le fournisseur de sa recherche de texte.
Le centre d’aide indique que Claude appelle un outil de recherche pour les sujets d’actualité, avec des citations directes, des liens et, si pertinent, des extraits.
La documentation de l’API apporte des détails concrets. Claude peut lancer plusieurs recherches dans un même tour : en général 1 à 3 pour une question simple, 10 ou plus pour une comparaison multi-entités.
Les citations y sont toujours activées, avec l’URL, le titre et jusqu’à 150 caractères de texte cité.
Un seul fournisseur est nommé dans l’aide de Claude, et uniquement pour les images : Bing. Pour la recherche de texte, aucune page d’Anthropic que j’ai lue ne dit quel index est interrogé.
Je m’en tiens donc à ce qui est écrit.
Anthropic distingue trois robots. ClaudeBot collecte des contenus pour l’entraînement, Claude-User récupère une page à la demande d’un utilisateur.
Et Claude-SearchBot ? Il parcourt le web pour améliorer la qualité des résultats, et le bloquer peut réduire la visibilité du site.
Selon la page crawler, bloquer les adresses IP est peu fiable, car le robot ne peut plus lire le robots.txt.
Selon la documentation de l’API d’Anthropic, Claude lance en général 1 à 3 recherches pour une question simple, 10 ou plus pour une comparaison multi-entités. Citations toujours activées, avec jusqu’à 150 caractères de texte cité.
Que disent vraiment les documentations sur l’index de chaque moteur ?
Google et Perplexity décrivent leur source de résultats, OpenAI la décrit de façon générale, et Anthropic ne la nomme pas pour le texte. Le tableau reprend uniquement ce que les pages officielles écrivent.
Pour le cadre général, voyez mon article GEO ou SEO.
| Moteur | Source des résultats documentée | Robot de recherche | Citations |
|---|---|---|---|
| ChatGPT Search | Fournisseurs de recherche tiers et contenus de partenaires, aucun fournisseur unique nommé | OAI-SearchBot | Citations et bouton Sources, parfois incomplètes ou périmées |
| Perplexity | Index et infrastructure décrits par Perplexity | PerplexityBot | Citations numérotées, labels sur certains domaines |
| Google AI Overviews et AI Mode | Index de Google Search, page indexée et éligible à un extrait | Googlebot | Liens d’appui, différents selon la fonctionnalité |
| Claude | Fournisseur de la recherche de texte non nommé (Bing nommé pour les images) | Claude-SearchBot | Citations avec liens et extraits, toujours actives dans l’API |
Lisez la colonne du milieu avec méfiance. Un moteur qui ne nomme pas son fournisseur ne prouve pas l’absence de fournisseur.
Cela prouve seulement que l’information n’est pas publique. Tout ce qui circule d’autre sur le sujet relève de l’hypothèse.
Un moteur qui ne nomme pas son fournisseur ne prouve pas l’absence de fournisseur. Cela prouve seulement que l’information n’est pas publique. Tout le reste relève de l’hypothèse.
Quels robots autoriser pour ne fermer aucune porte ?
Pour être éligible à la recherche de chaque moteur, il faut autoriser son robot de recherche. Les documentations séparent bien ce rôle de celui du robot d’entraînement.
Vous gérez chacun dans votre robots.txt. Voici le mémo, moteur par moteur.
Un robots.txt qui laisse entrer les robots de recherche
Cliquez sur une pastille numérotée pour lire l’explication de la zone.
User-agent: OAI-SearchBot
Allow: /
User-agent: PerplexityBot
Allow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: Googlebot
Allow: /
User-agent: Google-Extended
Disallow: /
- OpenAI : OAI-SearchBot pour la recherche, GPTBot pour l’entraînement, ChatGPT-User pour les actions d’un utilisateur.
- Perplexity : PerplexityBot pour apparaître dans les résultats, Perplexity-User pour les consultations à la demande.
- Google : Googlebot pour Search, donc pour AI Overviews et AI Mode. Google-Extended concerne l’entraînement et l’ancrage de Gemini.
- Anthropic : Claude-SearchBot pour la recherche, ClaudeBot pour l’entraînement, Claude-User pour les requêtes d’utilisateurs.
Autoriser un robot ouvre une possibilité de découverte, sans offrir de droit à la citation. Aucune documentation ne promet l’inverse.
Si vous hésitez sur ce que vous voulez laisser passer, j’ai détaillé le dilemme dans mon article sur le blocage de GPTBot.
Pour chaque moteur, autorisez le robot de recherche et gérez à part le robot d’entraînement : OAI-SearchBot / GPTBot, PerplexityBot / Perplexity-User, Googlebot / Google-Extended, Claude-SearchBot / ClaudeBot.
Comment vérifier que ces moteurs peuvent lire votre site ?
La vérification se fait en trois endroits : le robots.txt, la couche réseau (hébergeur, CDN, pare-feu) et l’indexation Google. Si un moteur ne peut pas lire une page, il ne peut pas la citer.
Je pose souvent la question à mes clients : « Votre robots.txt, vous l’avez déjà ouvert ? » La réponse tient en un silence gêné, puis en un « euh, non ».
Rassurez-vous, ça s’ouvre en dix secondes. Mon diagnostic complet figure dans l’article sur les sites invisibles dans ChatGPT.
Ouvrez le fichier robots.txt de votre site et cherchez OAI-SearchBot, PerplexityBot, Claude-SearchBot et Googlebot. Si l’un d’eux est bloqué sans raison, corrigez-le, puis laissez jusqu’à 24 heures à OpenAI et à Perplexity pour en tenir compte.
Ensuite, demandez à votre hébergeur si les adresses IP publiées par OpenAI (openai.com/searchbot.json) et par Perplexity (perplexity.com/perplexitybot.json) passent le CDN. Dans Search Console, l’inspection d’URL confirme que Googlebot reçoit bien vos directives.
Ouvrez votre robots.txt (dix secondes), puis demandez à votre hébergeur si les adresses IP publiées par OpenAI et Perplexity passent le CDN. Laissez jusqu’à 24 heures avant de conclure.
Questions fréquentes sur les sources des moteurs IA
ChatGPT Search utilise-t-il l’index d’un moteur de recherche précis ?
OpenAI écrit que ChatGPT Search s’appuie sur des fournisseurs de recherche tiers et sur des contenus de partenaires, sans nommer un fournisseur unique pour l’ensemble du service. Je ne peux donc pas vous dire quel index se trouve derrière chaque réponse.
Bloquer GPTBot m’empêche-t-il d’apparaître dans ChatGPT Search ?
GPTBot et OAI-SearchBot sont deux robots distincts, l’un pour l’entraînement, l’autre pour la recherche. Chacun se règle séparément dans le robots.txt. Pour la recherche, c’est l’accès d’OAI-SearchBot qui compte.
Faut-il être bien classé sur Google pour être cité par les autres moteurs ?
Seul Google documente un lien direct avec son index : la page doit être indexée et éligible à un extrait. OpenAI et Perplexity parlent de leurs propres facteurs de classement sans les publier. Un bon classement Google ne dit rien de ce qu’un autre moteur choisira.
Google-Extended contrôle-t-il l’affichage dans AI Overviews ?
Google précise que Google-Extended n’affecte ni l’inclusion ni le classement dans Google Search. Pour limiter l’affichage de vos contenus dans la Recherche, la documentation cite nosnippet, data-nosnippet, max-snippet et noindex.
Claude cite-t-il toujours ses sources ?
Le centre d’aide d’Anthropic indique que les réponses de recherche incluent des citations directes et des liens. Dans l’API, les citations web sont toujours activées.
Comment savoir si ChatGPT m’envoie des visiteurs ?
OpenAI ajoute le paramètre utm_source=chatgpt.com aux liens de référence, ce qui permet de les isoler dans Google Analytics. Cela suppose que OAI-SearchBot puisse accéder à votre contenu. Mon protocole de mesure va plus loin.
Faire auditer sa visibilité dans les moteurs IA par un professionnel
Chaque moteur a ses robots, ses règles et ses zones d’ombre, et un réglage oublié suffit à vous rendre illisible. Je vérifie votre robots.txt, votre couche réseau et vos pages, puis je teste vos vraies questions clients sur chaque moteur.
Vous repartez avec une liste d’actions classées, sans promesse de citation : aucun moteur ne la garantit. Vous savez ce qui bloque, ce qui se corrige tout de suite, et ce qui relève du contenu.
Ce qu’il faut retenir
- Aucun moteur ne publie sa formule de sélection des sources.
- OAI-SearchBot, PerplexityBot et Claude-SearchBot sont les robots de recherche à autoriser, GPTBot et ClaudeBot relèvent de l’entraînement.
- Google exige une page indexée et éligible à un extrait pour AI Overviews et AI Mode.
- Perplexity décrit un classement par passages, d’où l’intérêt de paragraphes autonomes.
- Anthropic nomme Bing pour les images, pas de fournisseur pour la recherche de texte.
- Autoriser un robot n’offre aucune garantie de citation.
- Vérifiez aussi l’hébergeur et le CDN, pas seulement le robots.txt.
Pour mesurer ce que chaque moteur dit de vous, lisez mon protocole de mesure de la visibilité IA.
Sources : OpenAI, Searching the web with ChatGPT · OpenAI, Introducing ChatGPT search · OpenAI, Overview of OpenAI crawlers · OpenAI, Publishers and developers FAQ · Perplexity, Architecting and evaluating an AI-first search API · Perplexity, How does Perplexity work · Perplexity, Understanding source labels · Perplexity, Crawlers · Google Search Central, AI features and your website · Google Search Central, Google common crawlers · Anthropic, Enable and use web search · Anthropic, Web search tool (API) · Anthropic, Does Anthropic crawl data from the web
Vous avez une question, un projet ? Parlons-en ensemble.
 On discute ?