
Je vois régulièrement passer des tableaux de bord de visibilité IA. Une marque était citée dans 42 % des réponses le mois dernier. Elle monte à 51 % ce mois-ci. Neuf points de gagnés. Champagne ?
Hum. Je regarderais d’abord combien de prompts ont été suivis.
Avec 30 prompts, la marge d’erreur dépasse largement dix points. Le fameux passage de 42 % à 51 % peut donc très bien venir de la mesure elle-même.
Oui, ça calme un peu.
Pour construire une mesure de visibilité IA exploitable, j’utilise sept règles : prompts figés, exécutions multiples, sessions propres, cadence stable, baseline, concurrents suivis en parallèle et une variable à la fois.
Et surtout, j’ajoute un élément que je vois encore rarement dans les rapports : un seuil de significativité calculé.
Par Alexandre Montenon, consultant GEO à Lyon
Pourquoi la mesure de visibilité IA varie-t-elle autant ?
Au début, je pourrais être tenté de faire quelque chose de très simple. Je pose mes questions à ChatGPT, je note les marques citées et je compare le mois suivant.
Sur le principe, ça se tient.
Dans la réalité, cinq sources de variation viennent se superposer. Et là, les choses deviennent nettement plus sportives.
Le non-déterminisme du modèle. Je pose deux fois exactement la même question. Deux réponses peuvent sortir. Les marques citées changent. Les sources aussi. C’est le fonctionnement normal d’un modèle génératif.
Le mode de raisonnement. Environ 25,6 % des domaines cités se retrouvent à la fois dans les modes de raisonnement minimal et élevé de ChatGPT.
Autrement dit, je change le mode et je peux aussi changer une bonne partie des sources visibles. Détail ? Vraiment loin de là.

La personnalisation. Historique de conversation, mémoire activée, compte connecté… Tous ces éléments peuvent modifier une réponse.
Du coup, si je lance mes relevés depuis mon compte habituel, avec des mois de conversations derrière moi, je mesure aussi une partie de mon propre historique. Ce qui était rarement l’objectif au départ.
La localisation. Pays, langue, contexte géographique : là encore, les réponses évoluent.
Tester une marque française depuis une IP américaine, avec des prompts anglais, puis tirer des conclusions sur sa visibilité en France… Je serais assez prudent avec le graphique final.
Les mises à jour de modèle. Elles peuvent redistribuer très fortement les citations. En septembre 2025, la part de Reddit dans les citations de ChatGPT a chuté d’environ 50 points en deux semaines.
Deux semaines.
Un relevé qui chevauche une évolution de ce type compare donc deux systèmes dont le comportement a changé entre-temps.
Les sept règles de mon protocole
1. Je fige et je versionne mes prompts
Première règle : une fois ma liste établie, je la garde.
Je résiste donc à la petite envie de modifier une question ici, d’ajouter un mot là ou de reformuler trois prompts parce que « ce sera mieux comme ça ».
Pourquoi ? Parce qu’à chaque modification, je réduis la comparabilité avec mes relevés précédents.
Quand une évolution devient nécessaire, je crée une version 2. Puis je conserve la version 1 en parallèle pendant au moins deux relevés.
Je peux alors voir le décalage entre les deux séries au lieu de mélanger les données.
Pour la structure, je recommande cinq prompts par catégorie suivie, avec cinq intentions :
- définition
- comparaison
- alternatives
- cas d’usage
- décision d’achat
Cette découpe reprend celle utilisée dans l’étude Semrush consacrée à la visibilité thématique dans ChatGPT, avec 1 094 catégories et plus de 600 000 citations.
Et, accessoirement, elle ressemble beaucoup au parcours d’un véritable acheteur. Ce qui m’intéresse davantage qu’une collection de prompts construite uniquement pour remplir un tableau.
2. Je dimensionne mon échantillon
C’est probablement le point qui me fait lever le sourcil le plus souvent.
Je vois une progression annoncée à +6 points. Puis je regarde l’échantillon : 25 ou 30 prompts.
Bon.
Avec un volume aussi réduit, je peux surtout détecter de gros bouleversements. Pour mesurer des mouvements plus fins, il me faut davantage de prompts distincts.
Je multiplie également les exécutions. Trois à cinq passages par prompt constituent une base raisonnable pour lisser une partie du non-déterminisme.
Attention toutefois : répéter cinq fois un même prompt crée cinq réponses corrélées autour du même point. J’y reviens juste après, car cette nuance change beaucoup de choses.
3. Je travaille en session propre
Pour chaque relevé, je recrée le même environnement. Sinon, je rajoute moi-même des variables à une mesure qui en possède déjà largement assez.
- navigation privée ou profil dédié
- compte déconnecté ou compte neuf avec historique vierge
- mémoire désactivée quand l’option existe
- localisation française et langue française
- mode de raisonnement identique et documenté
Le dernier point mérite une petite étoile rouge dans mon protocole.
Avec environ 25 % de recouvrement entre les domaines cités selon les modes, changer de mode entre deux relevés revient presque à changer de moteur au milieu de l’expérience.
Évidemment, derrière, la courbe bouge.
4. Je garde une cadence stable
Pour la majorité des marchés, je préfère un relevé mensuel, réalisé à date fixe.
Une mesure hebdomadaire peut se défendre sur un secteur très mouvant. Elle augmente aussi fortement le nombre de petites variations que je pourrais être tenté de commenter.
Et c’est précisément là que commence le piège.
Avec une cadence irrégulière, je compare parfois trois semaines d’écart avec six semaines d’écart. Puis j’essaie de raconter une tendance cohérente avec tout ça.
Je préfère donc une cadence stable.
5. J’établis une baseline, puis je laisse du temps
Avant de toucher au site, je mesure la situation initiale.
C’est ma baseline. Mon point zéro.
Ensuite seulement, je travaille.
Et là arrive une autre tentation très humaine : vérifier trois jours plus tard si tout a bougé.
Pour un gain structurel on-page, quelques semaines peuvent déjà produire un effet visible. Pour la reconnaissance d’entité, je raisonne plutôt sur trois à neuf mois. Pour l’earned media, la fenêtre peut atteindre six à douze mois.
Une campagne de presse lancée depuis six semaines peut donc être encore très jeune.
Une conclusion tirée aussi tôt renseigne surtout sur le moment choisi pour la mesure.
6. Je suis les concurrents en parallèle
Ma marque perd cinq points de part de mentions.
Mauvaise nouvelle ?
Attendez.
Si tous les concurrents perdent dix points dans le même temps, la lecture devient très différente.
C’est pour cette raison que je suis trois à cinq concurrents sur les mêmes prompts et lors du même relevé.
Je peux alors distinguer une évolution générale du marché d’un mouvement propre à la marque.
7. Je fais varier une seule variable
Je réécris mes pages. Je lance une campagne de presse. J’ajoute du schema. Le tout pendant le même mois.
Puis la visibilité monte.
Très bien. Quelle action a produit l’effet ? Là, ça devient beaucoup plus compliqué.
Quand le calendrier le permet, je préfère séquencer les actions.
Dans la vraie vie, plusieurs chantiers avancent souvent en même temps. Dans ce cas, je segmente au minimum mes relevés et je suis séparément les prompts concernés par chaque action.
Quel seuil de significativité utiliser pour une mesure de visibilité IA ?
C’est ici que les choses deviennent vraiment intéressantes.
Et, étrangement, c’est aussi la partie que je vois disparaître de beaucoup de rapports.
Une part de mentions est une proportion. Sa marge d’erreur dépend du nombre d’observations indépendantes.
Le mot important, ici, c’est « indépendantes ».
Si je pose cinq fois le même prompt, j’obtiens bien cinq réponses. J’obtiens surtout cinq mesures corrélées d’un même point.
Mon échantillon effectif se rapproche donc davantage du nombre de prompts distincts que du nombre total d’exécutions.
Avec une approximation d’intervalle de confiance à 95 % pour une proportion proche de 50 %, j’arrive aux ordres de grandeur suivants :
| Nombre de prompts | Marge d’erreur approximative |
|---|---|
| 30 | ± 18 points |
| 50 | ± 14 points |
| 100 | ± 10 points |
| 200 | ± 7 points |
| 400 | ± 5 points |
Et là, mon joli +9 points du début prend une autre couleur.
Avec 30 prompts, passer de 42 % à 51 % reste compatible avec une situation stable.
Avec 200 prompts, en revanche, dix points d’écart commencent à devenir beaucoup plus intéressants.
Je garde tout de même trois précautions.
Premièrement, cette approximation suppose des prompts raisonnablement indépendants. Cinquante variantes presque identiques d’une même question réduisent l’échantillon effectif.
Deuxièmement, la marge se resserre lorsque la proportion mesurée s’éloigne de 50 %.
Troisièmement, ce calcul couvre l’erreur d’échantillonnage. Un mauvais choix de prompts peut créer un biais systématique que l’intervalle de confiance ne corrigera jamais.
Ma règle opérationnelle : sous 100 prompts, une variation inférieure à dix points reste pour moi une observation à confirmer lors du relevé suivant.
Que mesurer exactement ?
Une fois le protocole posé, reste une question assez évidente : je mesure quoi ?
Pour ma mesure de visibilité IA, je conserve quatre indicateurs distincts.
La part de mentions. Sur toutes les réponses générées, dans quelle proportion ma marque apparaît-elle ?
C’est l’indicateur que je regarde en premier.
Dans les travaux cités par Semrush sur la visibilité thématique dans ChatGPT, 74 % des utilisateurs ont retenu la marque placée en tête comme choix final.
La part de citations. Là, je regarde autre chose : parmi les sources listées, quelle proportion pointe vers mes propres pages ?
Et surtout, je garde ces deux métriques séparées.
Pourquoi ? Parce que seulement 21 % des domaines les plus cités dans une catégorie correspondent aussi à la marque la plus mentionnée.
La corrélation entre les deux est même légèrement négative.
Du coup, quand un tableau de bord fusionne tout ça dans un grand « score de visibilité IA », je perds justement une partie de l’information qui m’intéresse.
Le sentiment. Ma marque est citée, d’accord. Mais comment ? Favorablement ? De manière neutre ? Défavorable ?
Une mention défavorable peut peser davantage qu’une absence de mention. Les moteurs peuvent aussi reprendre le sentiment présent dans leurs sources.
Les sources tierces. Enfin, je regarde quels domaines le moteur utilise pour parler du sujet.
Et là, j’obtiens quelque chose de très concret : une carte des médias, sites et plateformes où ma marque aurait intérêt à exister.
Comment je structure mon relevé
Pour stocker les données, je reste très terre-à-terre : un tableau, une ligne par exécution.
Chaque ligne contient au minimum les informations suivantes :
| Colonne | Contenu |
|---|---|
| Date | Date du relevé |
| Prompt ID | Identifiant stable, plutôt que le texte du prompt |
| Version | Version de la liste de prompts |
| Moteur | ChatGPT, Perplexity, Aperçus IA, Mode IA, Claude… |
| Mode | Mode de raisonnement utilisé |
| Exécution | 1 à 5 |
| Marque mentionnée | Oui / Non |
| Sentiment | Positif / Neutre / Négatif |
| Position dans la réponse | Début / Milieu / Fin |
| Concurrents cités | Liste |
| Sources citées | Liste de domaines |
| Notre URL citée | Oui / Non, avec l’URL concernée |
Pourquoi une ligne par exécution plutôt qu’une ligne par prompt ?
Parce que je veux conserver les variations entre les réponses.
C’est justement cette granularité qui me permet ensuite de calculer la variance et de voir si un mouvement ressemble davantage à un signal ou à une fluctuation.
Je croise la mesure de visibilité IA avec mes données propriétaires
Mon relevé sur prompts répond à une question : est-ce que la marque apparaît ?
Il répond moins bien à une autre question : qu’est-ce que cette visibilité produit réellement ?
Du coup, je complète toujours la mesure de visibilité IA avec trois sources que je contrôle.
Mes logs serveur. Je regarde quels crawlers IA visitent le site, leur fréquence de passage, les pages consultées et les codes de réponse.
Cette donnée me permet de voir quelles pages les plateformes viennent réellement chercher.
Elle révèle aussi un problème beaucoup plus terre-à-terre : un pare-feu peut bloquer un crawler. Dans ce cas, plusieurs mois de courbes deviennent nettement moins instructifs.
Bing Webmaster Tools. Depuis février 2026, le rapport AI Performance fournit les citations, les pages citées et les grounding queries.
Pour une fois, je dispose donc de données directement issues du moteur.

Mon outil analytics. Je crée également un segment avec les referrers connus : chatgpt.com, perplexity.ai, gemini.google.com, claude.ai et copilot.microsoft.com.
Là, je quitte les mentions théoriques. Je regarde des visites et des conversions réelles.
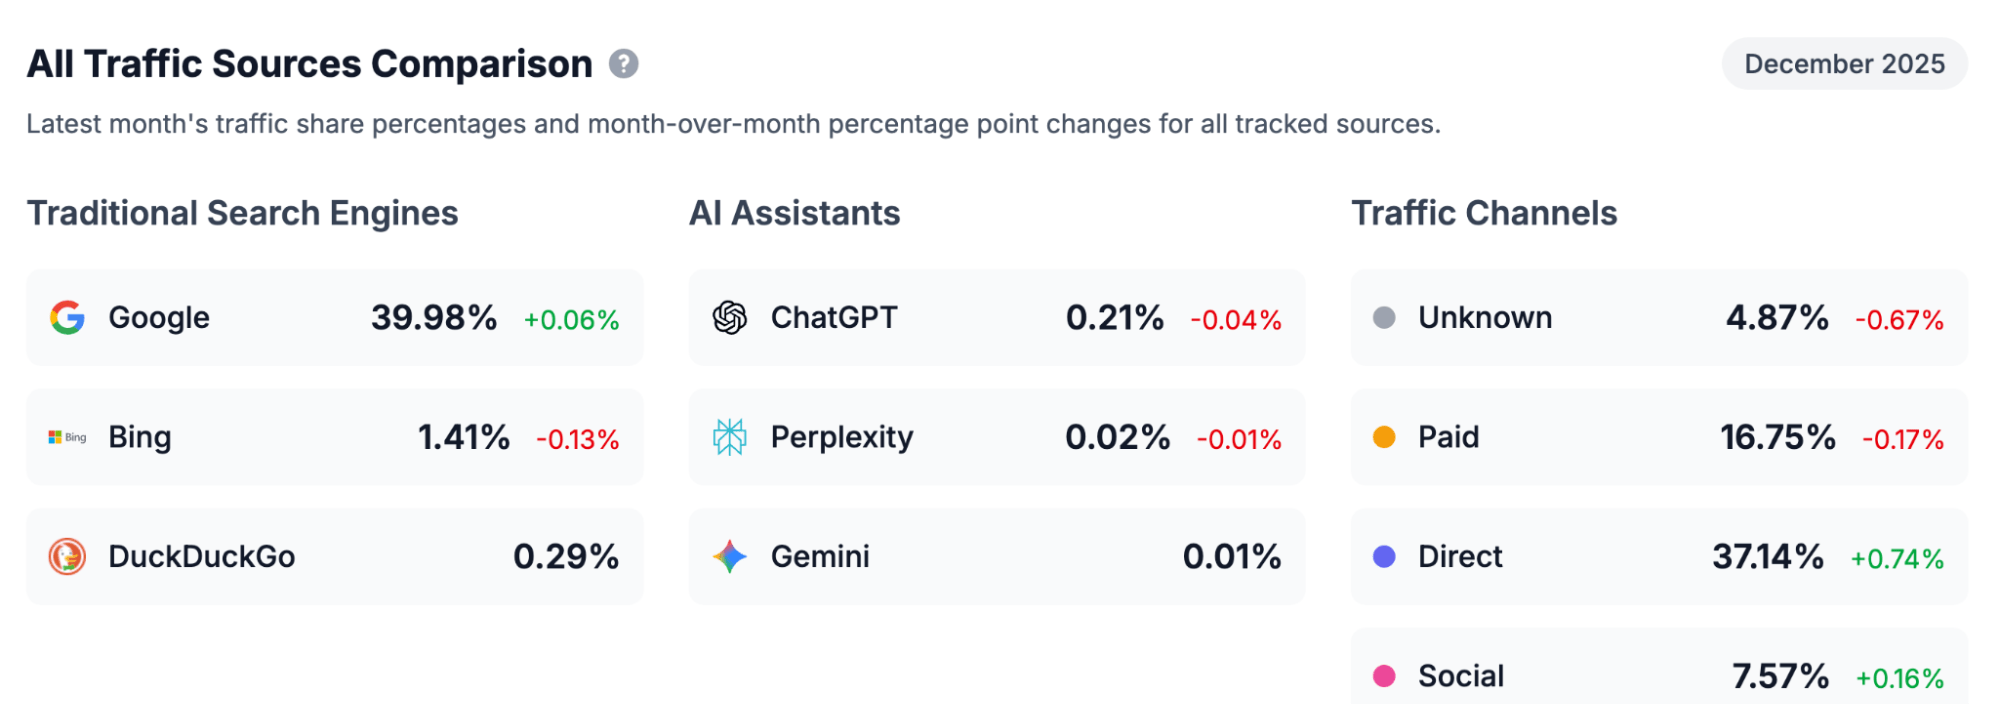
Les volumes restent modestes : ChatGPT représente environ 0,21 % du trafic web, contre 39,98 % pour Google, dans les données publiées par Ahrefs à partir de son échantillon Web Analytics.
La Search Console fournit également les impressions liées aux surfaces génératives depuis juin 2026.
Les données restent cependant agrégées entre Aperçus IA et Mode IA, avec une visibilité limitée sur les requêtes et les clics.
Questions fréquentes
Combien de prompts faut-il suivre pour un relevé fiable ?
Je vise au moins 100 prompts lorsque je veux interpréter des variations proches de dix points.
Sous 50 prompts, la marge d’erreur dépasse 14 points. Beaucoup de petits mouvements deviennent donc très difficiles à distinguer d’une simple fluctuation.
Entre 500 prompts exécutés une fois et 100 prompts exécutés trois fois chacun, je préfère généralement la seconde approche.
Combien de fois faut-il répéter chaque prompt ?
Trois à cinq exécutions constituent une bonne base.
Elles servent surtout à lisser la variabilité du modèle.
Je garde cependant en tête que ces répétitions restent corrélées. Ma puissance statistique dépend surtout du nombre de prompts distincts.
Faut-il tester en étant connecté à son compte ?
Pour un relevé comparable dans le temps, je travaille avec une session propre.
Un compte connecté peut intégrer la mémoire et l’historique des conversations dans la réponse. Et je préfère mesurer la visibilité de la marque plutôt que mes habitudes personnelles.
J’utilise donc une session déconnectée ou un compte neuf, avec la mémoire désactivée quand cette option existe.
À quelle fréquence mesurer ?
Mensuellement, à date fixe, dans la plupart des cas.
Une cadence hebdomadaire peut avoir du sens sur un secteur très mouvant. Elle multiplie aussi les petites variations à interpréter.
Ce qui m’intéresse surtout, c’est la régularité du protocole.
Combien de temps attendre après une action avant de mesurer son effet ?
Je garde généralement une fenêtre minimale de six à douze semaines.
Les évolutions structurelles on-page peuvent apparaître en quelques semaines. La reconnaissance d’entité se joue davantage sur trois à neuf mois. L’earned media peut composer pendant six à douze mois.
Au bout d’un mois, j’ai donc souvent davantage une première photographie qu’un verdict.
Un outil payant applique-t-il ce protocole ?
Le tarif de l’outil me renseigne assez peu là-dessus.
En démonstration, je pose quatre questions très simples : combien d’exécutions par prompt ? À quelle fréquence ? Depuis quelle localisation ? Avec quel niveau de personnalisation ?
Si les réponses deviennent soudain très vagues, je regarde les beaux graphiques avec davantage de recul.
Sources
- Semrush, AI visibility is a topic-level game: A study of 50,000 brands in ChatGPT, juillet 2026, avec Kevin Indig. 1 094 catégories, 600 000 citations
- Semrush, Only 25% of cited sources overlap between ChatGPT’s different reasoning modes, juin 2026
- Ahrefs, ChatGPT Has 12% of Google’s Search Volume but Google Sends 190x More Traffic, février 2026
- Microsoft Bing Webmaster Blog, Introducing AI Performance in Bing Webmaster Tools, 10 février 2026
- Microsoft Bing, New AI Visibility Insights in Bing Webmaster Tools, 16 juin 2026
- Google Search Central, Optimizing your website for generative AI features on Google Search, mai 2026, mis à jour le 10 juillet 2026