 On discute ?
« Alexandre, comment fonctionnent les Crawlers IA, leurs user-agents et le robots.txt ? »
Quand je regarde un fichier robots.txt, je vois encore souvent tous les Crawlers IA rangés dans la même case. GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot… Un robot reste un robot, non ?
Lecture : 18 minutes
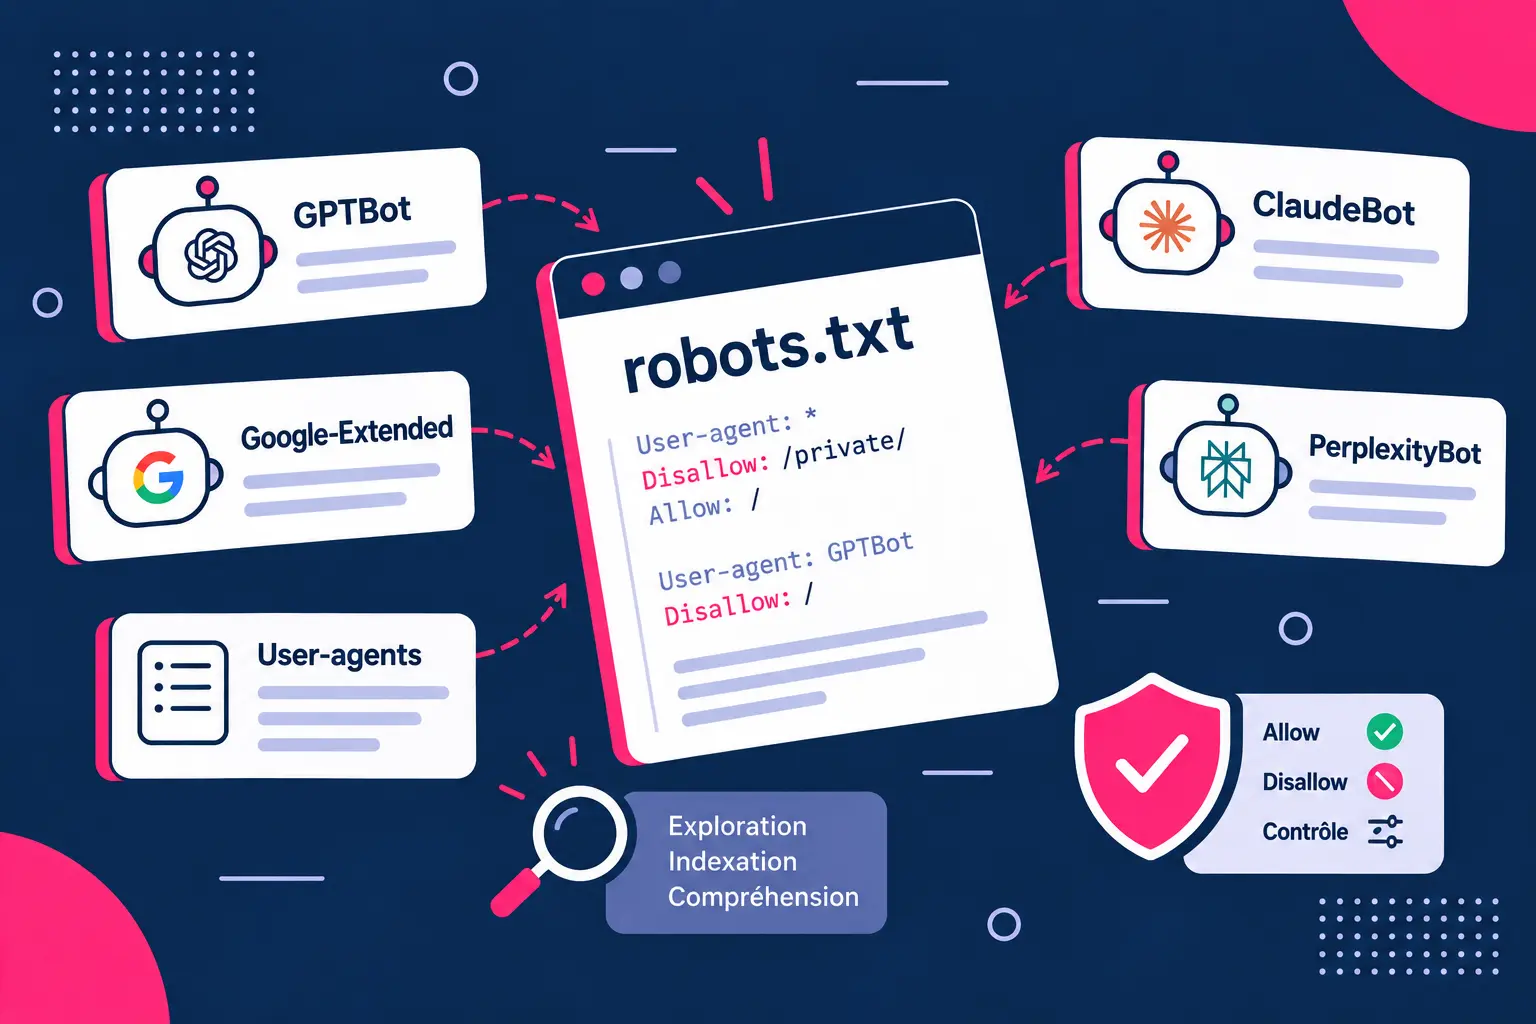
Chaque éditeur d’IA a plusieurs crawlers, pour trois usages : l’entraînement, l’indexation de recherche et la récupération à la demande.
On règle donc son robots.txt agent par agent, en sachant ce que chaque blocage fait perdre.
Eh bien, justement : chaque agent possède sa propre fonction.
Les principaux éditeurs d’IA en utilisent plusieurs. Et chacun a son métier.
Ça ressemble à un détail technique. Pourtant, le choix du bon user-agent change complètement la configuration.
Une mauvaise directive dans le robots.txt peut écarter un site des réponses générées tout en laissant ses contenus accessibles pour l’entraînement.
Le réglage produit alors exactement l’effet inverse de celui recherché.
- Un crawler collecte du contenu pour l’entraînement des modèles
- Un autre indexe les pages utilisées pendant une recherche
- Un troisième intervient lorsqu’un utilisateur demande directement à son assistant de consulter une URL
01Pourquoi chaque éditeur a-t-il plusieurs crawlers ?
Parce que derrière le mot « crawler », je retrouve en réalité trois usages très différents.
Et quand on les mélange, les erreurs arrivent vite.
- L’entraînement consiste à collecter du contenu pour alimenter les futures versions du modèle
- L’indexation de recherche alimente un index interrogé en temps réel
- La récupération déclenchée par l’utilisateur intervient lorsqu’un humain demande à son assistant de consulter une page précise
Commençons par l’entraînement.
Le robot collecte du contenu aujourd’hui pour nourrir les futures versions du modèle.
Une page récupérée en 2026 peut donc influencer une réponse générée bien plus tard, avec une citation qui dépendra alors d’un autre mécanisme.
L’indexation de recherche fonctionne différemment.
Le crawler alimente un index que l’assistant interroge au moment où l’utilisateur formule sa question. C’est ce système qui permet ensuite d’afficher des liens sources sous une réponse.
Dernier cas : la récupération déclenchée par l’utilisateur.
Quelqu’un colle votre URL dans une conversation. Ou demande directement à son assistant de lire une page précise. L’IA vient alors récupérer le contenu à la demande.
L’action vient d’un humain. Le statut technique et juridique de la requête change donc avec elle.
La conséquence devient assez simple à comprendre : un site peut bloquer le crawler d’entraînement tout en conservant sa visibilité dans les réponses avec recherche.
L’inverse existe également.
D’où l’intérêt de lire les Crawlers IA séparément.
Quels sont les trois usages d’un crawler IA ?
Réponse : Entraînement, indexation de recherche, récupération déclenchée par l’utilisateur. Trois usages très différents. Les mélanger, c’est la source de la plupart des erreurs de robots.txt.
02Les Crawlers IA d’OpenAI
Chez OpenAI, la séparation est particulièrement nette.
OpenAI documente quatre agents distincts.
| User-agent | Rôle | Effet du blocage |
|---|---|---|
OAI-SearchBot |
Indexation pour la recherche ChatGPT | Votre site sort des réponses issues de la recherche ChatGPT. Il peut rester accessible via un lien de navigation |
GPTBot |
Collecte pour l’entraînement des modèles | Vos futurs contenus restent hors des jeux d’entraînement |
ChatGPT-User |
Récupération déclenchée par un utilisateur et GPT Actions | Les pages cessent d’être récupérables à la demande |
OAI-AdsBot |
Vérification des pages d’atterrissage publicitaires | Effet neutre sur la visibilité éditoriale |
Le tableau donne déjà une bonne vue d’ensemble.
Mais trois détails techniques méritent vraiment qu’on s’y arrête.
- OpenAI publie ses plages d’IP dans des fichiers JSON dédiés
- Une mention
robots.txtapparaît dans le user-agent lors de la récupération de ce fichier - Une modification demande environ 24 heures pour se propager côté recherche OpenAI
Le premier point est particulièrement utile.
Un user-agent se copie très facilement. Un script peut envoyer une requête en se présentant comme GPTBot.
Pour vérifier sérieusement l’identité du crawler, je regarde donc son adresse IP plutôt que la simple chaîne déclarée.
OpenAI publie justement des fichiers dédiés comme searchbot.json ou gptbot.json.
La mention robots.txt facilite ensuite la lecture des logs. Elle permet d’identifier la requête effectuée spécialement pour récupérer ce fichier.
Quant au délai de propagation, je garde environ 24 heures en tête après chaque modification côté recherche OpenAI.
Quel agent OpenAI alimente la recherche ChatGPT ?
Réponse : OAI-SearchBot. OAI-SearchBot. Le bloquer sort votre site des réponses issues de la recherche ChatGPT. GPTBot, lui, sert à l’entraînement des modèles.
Combien de temps compter pour qu’une modification du robots.txt soit prise en compte côté recherche OpenAI ?
Réponse : Environ 24 heures. Environ 24 heures. Testez après le déploiement, pas pendant.
03Les Crawlers IA d’Anthropic
Chez Anthropic, je retrouve la même logique en trois catégories.
| User-agent | Rôle | Effet du blocage |
|---|---|---|
Claude-SearchBot |
Indexation pour la recherche Claude | Anthropic indique une réduction possible de la visibilité et de l’exactitude du site dans les recherches |
ClaudeBot |
Collecte pour l’entraînement | Les futurs contenus restent hors des jeux d’entraînement |
Claude-User |
Récupération pendant une conversation | Les pages cessent d’être récupérables lors des demandes utilisateurs |
Jusque-là, ça ressemble beaucoup à OpenAI.
Puis arrive Claude-User. Et là, petite différence : Claude-User respecte le robots.txt.
Anthropic adopte ici une approche plus stricte que plusieurs concurrents.
Claude-Userapplique les directives du robots.txtChatGPT-Userpeut être traité différemment lorsque l’action vient directement d’un humainPerplexity-Usersuit une logique comparable à celle d’OpenAI
Autre particularité : Anthropic publie zéro plage d’IP dédiée à ses crawlers.
L’entreprise déconseille d’ailleurs le blocage par IP.
Ses robots utilisent des infrastructures cloud partagées. Une adresse associée aujourd’hui à Claude peut appartenir demain à un autre service.
Anthropic prend en revanche en charge la directive Crawl-delay.
Quelle particularité pour Claude-User ?
Réponse : Il respecte le robots.txt. Claude-User applique les directives du robots.txt. Anthropic est ici plus strict que plusieurs concurrents, alors que ChatGPT-User peut être traité différemment quand l’action vient directement d’un humain.
04Les Crawlers IA de Perplexity
Perplexity fait plus simple.
Deux agents concentrent ici l’essentiel du fonctionnement.
| User-agent | Rôle | Effet du blocage |
|---|---|---|
PerplexityBot |
Indexation | Le texte intégral de vos pages sort de l’index |
Perplexity-User |
Récupération déclenchée par l’utilisateur | Le robots.txt reste généralement écarté pour cet agent |
Perplexity publie également des plages d’IP permettant de vérifier l’identité de ses robots.
Je peux donc croiser deux informations :
- Le user-agent déclaré
- L’adresse IP réellement utilisée
Et pour tester la visibilité d’une page dans les IA, j’aime bien Perplexity.
Pourquoi ? Parce que le moteur affiche ses sources de manière très visible.
Je pose une question, je regarde les citations, et je vois rapidement si ma page apparaît dans le circuit.
C’est assez confortable pour vérifier qu’un contenu reste accessible et extractible.
05Les Crawlers IA de Google
Chez Google, une confusion revient souvent.
Googlebot et Google-Extended remplissent deux fonctions très différentes.
| User-agent | Rôle | Effet du blocage |
|---|---|---|
Googlebot |
Index Search, qui alimente également les Aperçus IA et le Mode IA | Exclusion de Google, y compris des surfaces génératives |
Google-Extended |
Entraînement de Gemini et grounding associé | Exclusion de l’entraînement avec un classement Search inchangé |
Le point qui change toute la lecture du sujet tient en une phrase : Google utilise son index Search pour ses fonctionnalités génératives.
Les Aperçus IA et le Mode IA reposent donc sur l’index de recherche et sur les mêmes grands systèmes de classement.
Bloquer Googlebot pour quitter les Aperçus IA entraîne alors une conséquence bien plus large : le site sort aussi de Google Search.
Oui, l’effet est radical.
Google documente le fonctionnement de ses fonctionnalités génératives dans Search.
06Et les autres ?
OpenAI, Anthropic, Perplexity et Google concentrent une grosse partie de l’attention.
Mais la liste continue.
Bingbotpour Microsoft CopilotApplebot-Extendedpour l’entraînement AppleMeta-ExternalAgentpour MetaCCBotpour Common Crawl
Common Crawl mérite d’ailleurs un petit arrêt.
Ses archives ont historiquement servi de base à de nombreux corpus d’entraînement. Y compris chez des acteurs disposant ensuite de leurs propres crawlers.
Autoriser CCBot, c’est donc potentiellement laisser son contenu entrer indirectement dans de nombreux corpus externes.
Que se passe-t-il si vous autorisez CCBot, le crawler de Common Crawl ?
Réponse : Votre contenu peut entrer indirectement dans de nombreux corpus d’entraînement externes. Les archives de Common Crawl ont historiquement servi de base à de nombreux corpus d’entraînement, y compris chez des acteurs qui ont ensuite leurs propres crawlers.
07Que se passe-t-il vraiment quand on bloque ?
Bon. Venons-en à la question qui m’intéresse vraiment lorsque j’ouvre un robots.txt : qu’est-ce que je perds en bloquant tel ou tel agent ?
Parce qu’un Disallow paraît anodin. Une ligne, deux-points, un slash… et derrière, l’effet varie complètement selon le crawler concerné.
| Vous bloquez | Vous perdez | Vous gardez |
|---|---|---|
Les bots de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot) |
Toute présence dans les réponses citées de ces assistants | Le contrôle sur l’entraînement |
Les bots d’entraînement (GPTBot, ClaudeBot, Google-Extended) |
La présence de votre marque dans la mémoire du modèle, qui alimente les réponses hors recherche | La visibilité dans les réponses avec recherche |
Les bots utilisateur (ChatGPT-User, Claude-User, Perplexity-User) |
La possibilité qu’un prospect fasse analyser votre page par son assistant | L’essentiel de la visibilité liée aux autres agents |
| Tous | La quasi-totalité de votre visibilité IA | Votre contenu au sens juridique |
Voilà pourquoi je sépare toujours trois décisions :
- La recherche
- L’entraînement
- La récupération utilisateur
Mettre tous les Crawlers IA dans le même bloc revient à traiter trois sujets différents avec une seule règle.
Que perdez-vous en bloquant les bots de recherche (OAI-SearchBot, Claude-SearchBot, PerplexityBot) ?
Réponse : Toute présence dans les réponses citées de ces assistants. Toute présence dans les réponses citées de ces assistants. Vous gardez, en revanche, le contrôle sur l’entraînement.
Et en bloquant les bots utilisateur (ChatGPT-User, Claude-User, Perplexity-User) ?
Réponse : Vous perdez la possibilité qu’un prospect fasse analyser votre page par son assistant. Un prospect ne peut plus demander à son assistant de lire votre page. Un Disallow paraît anodin, mais son effet varie complètement selon le crawler.
08Faut-il autoriser l’entraînement ?
C’est ici que le sujet devient beaucoup plus stratégique.
Et la décision dépend entièrement du modèle économique.
Le cas d’un éditeur de presse
Son contenu constitue directement son produit.
Le laisser entrer gratuitement dans un modèle capable ensuite d’en restituer les informations hors clic et hors rémunération crée un transfert de valeur net.
En France, la loi de 2019 sur les droits voisins ajoute un cadre de négociation collective.
L’arbitrage devient donc à la fois :
- Technique
- Juridique
- Contractuel
Dans ce contexte, le blocage constitue souvent une position de départ rationnelle.
Le cas d’une marque qui vend un produit ou un service
Là, le raisonnement change complètement.
Le contenu sert à faire connaître l’entreprise et ses solutions.
Bloquer l’entraînement peut aussi éloigner la marque de la couche qui influence les entreprises spontanément citées par le modèle, avant même le déclenchement d’une recherche.
Une hypothèse testée sur plus de 360 000 réponses décrit justement ce mécanisme.
- Le modèle sélectionnerait d’abord les marques qu’il associe naturellement à une recommandation
- Il chercherait ensuite des sources capables d’étayer cette sélection
J’aime bien cette manière de regarder le fonctionnement.
La citation devient alors la bibliographie. La sélection de la marque intervient plus tôt.
Si cette lecture se confirme, bloquer l’entraînement peut donc éloigner une marque de cette première phase de sélection.
Le cas d’un site à contenu premium ou payant
Ici, une position intermédiaire revient souvent.
- Les crawlers de recherche accèdent aux pages publiques
- Les crawlers d’entraînement restent fermés
- Les espaces payants restent exclus de l’ensemble des agents
Et quelle que soit la décision, je la documente.
Parce qu’en audit, je rencontre régulièrement la même situation : une directive a été ajoutée des mois plus tôt, puis oubliée.
Plus personne ne sait qui l’a écrite. Encore moins pourquoi.
Une hypothèse testée sur plus de 360 000 réponses décrit le mécanisme ainsi : le modèle choisit d’abord une marque à recommander, puis cherche des sources pour étayer ce choix.
La citation devient alors la bibliographie. Si cette lecture se confirme, bloquer l’entraînement peut éloigner une marque de cette première phase de sélection.
Quelle que soit la décision, je la documente. En audit, je retrouve régulièrement une directive ajoutée des mois plus tôt, puis oubliée : plus personne ne sait qui l’a écrite, ni pourquoi.
Pour quel acteur le blocage de l’entraînement est-il souvent une position de départ rationnelle ?
Réponse : Un éditeur de presse. Pour un éditeur de presse, le contenu est le produit. Le laisser entrer gratuitement dans un modèle crée un transfert de valeur net, avec en France le cadre de la loi de 2019 sur les droits voisins.
Pour une marque qui vend un produit ou un service, que risque-t-on en bloquant l’entraînement ?
Réponse : De s’éloigner de la couche qui influence les marques citées spontanément par le modèle. Le contenu sert à faire connaître l’entreprise. Bloquer l’entraînement peut l’éloigner des marques que le modèle cite spontanément, avant même toute recherche.
J’ai détaillé cet arbitrage, cas par cas, dans faut-il bloquer GPTBot.
09Un robots.txt modèle
Voici une configuration adaptée à une marque qui recherche de la visibilité et accepte l’entraînement.
Le bloc consacré à l’entraînement reste à adapter selon l’arbitrage précédent.
# --- Recherche IA : autoriser ---
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# --- Récupération déclenchée par l'utilisateur ---
User-agent: ChatGPT-User
Allow: /

User-agent: Claude-User
Allow: /

User-agent: Perplexity-User
Allow: /

# --- Entraînement : décision stratégique ---
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: Google-Extended
Allow: /

# --- Zones à exclure de tous les agents ---
User-agent: *
Disallow: /admin/
Disallow: /panier/
Disallow: /compte/
Disallow: /*?filtre=

Sitemap: https://votresite.fr/sitemap.xml
Trois précautions méritent d’être gardées sous la main.
Allow: /sert surtout à documenter la décision. Un agent absent d’un bloc spécifique dispose déjà d’un accès par défaut- L’ordre et la spécificité comptent. Une organisation lisible réduit les erreurs humaines lorsque plusieurs règles cohabitent
- Testez après le déploiement. Côté OpenAI, la propagation demande environ 24 heures
Sur WordPress, ce fichier se règle depuis l’extension SEO, sans toucher au serveur. Je montre où dans GEO sur WordPress.
Et le llms.txt, censé guider les IA ? Mon avis, plutôt réservé, est dans le fichier llms.txt.
10Comment vérifier qu’un bot est bien celui qu’il prétend être ?
Le user-agent me donne une indication.
Je le considère surtout comme une déclaration.
Un script peut écrire GPTBot dans son en-tête et tenter de se faire passer pour lui. Des aspirateurs de contenu utilisent justement ce type de technique pour contourner certaines protections.
Du coup, je vérifie.
- Je récupère les plages d’IP officielles publiées par OpenAI et Perplexity dans leurs fichiers JSON
- Je croise l’adresse IP de la requête avec ces plages
- Pour Anthropic, j’utilise une résolution DNS inverse suivie d’une résolution directe
- Je journalise le user-agent, l’IP, le code de réponse et l’URL consultée
Les logs deviennent ici très intéressants.
Ils permettent de voir :
- Quel crawler vient sur le site
- Quelle page il consulte
- À quelle fréquence il revient
- Quel code HTTP lui est renvoyé
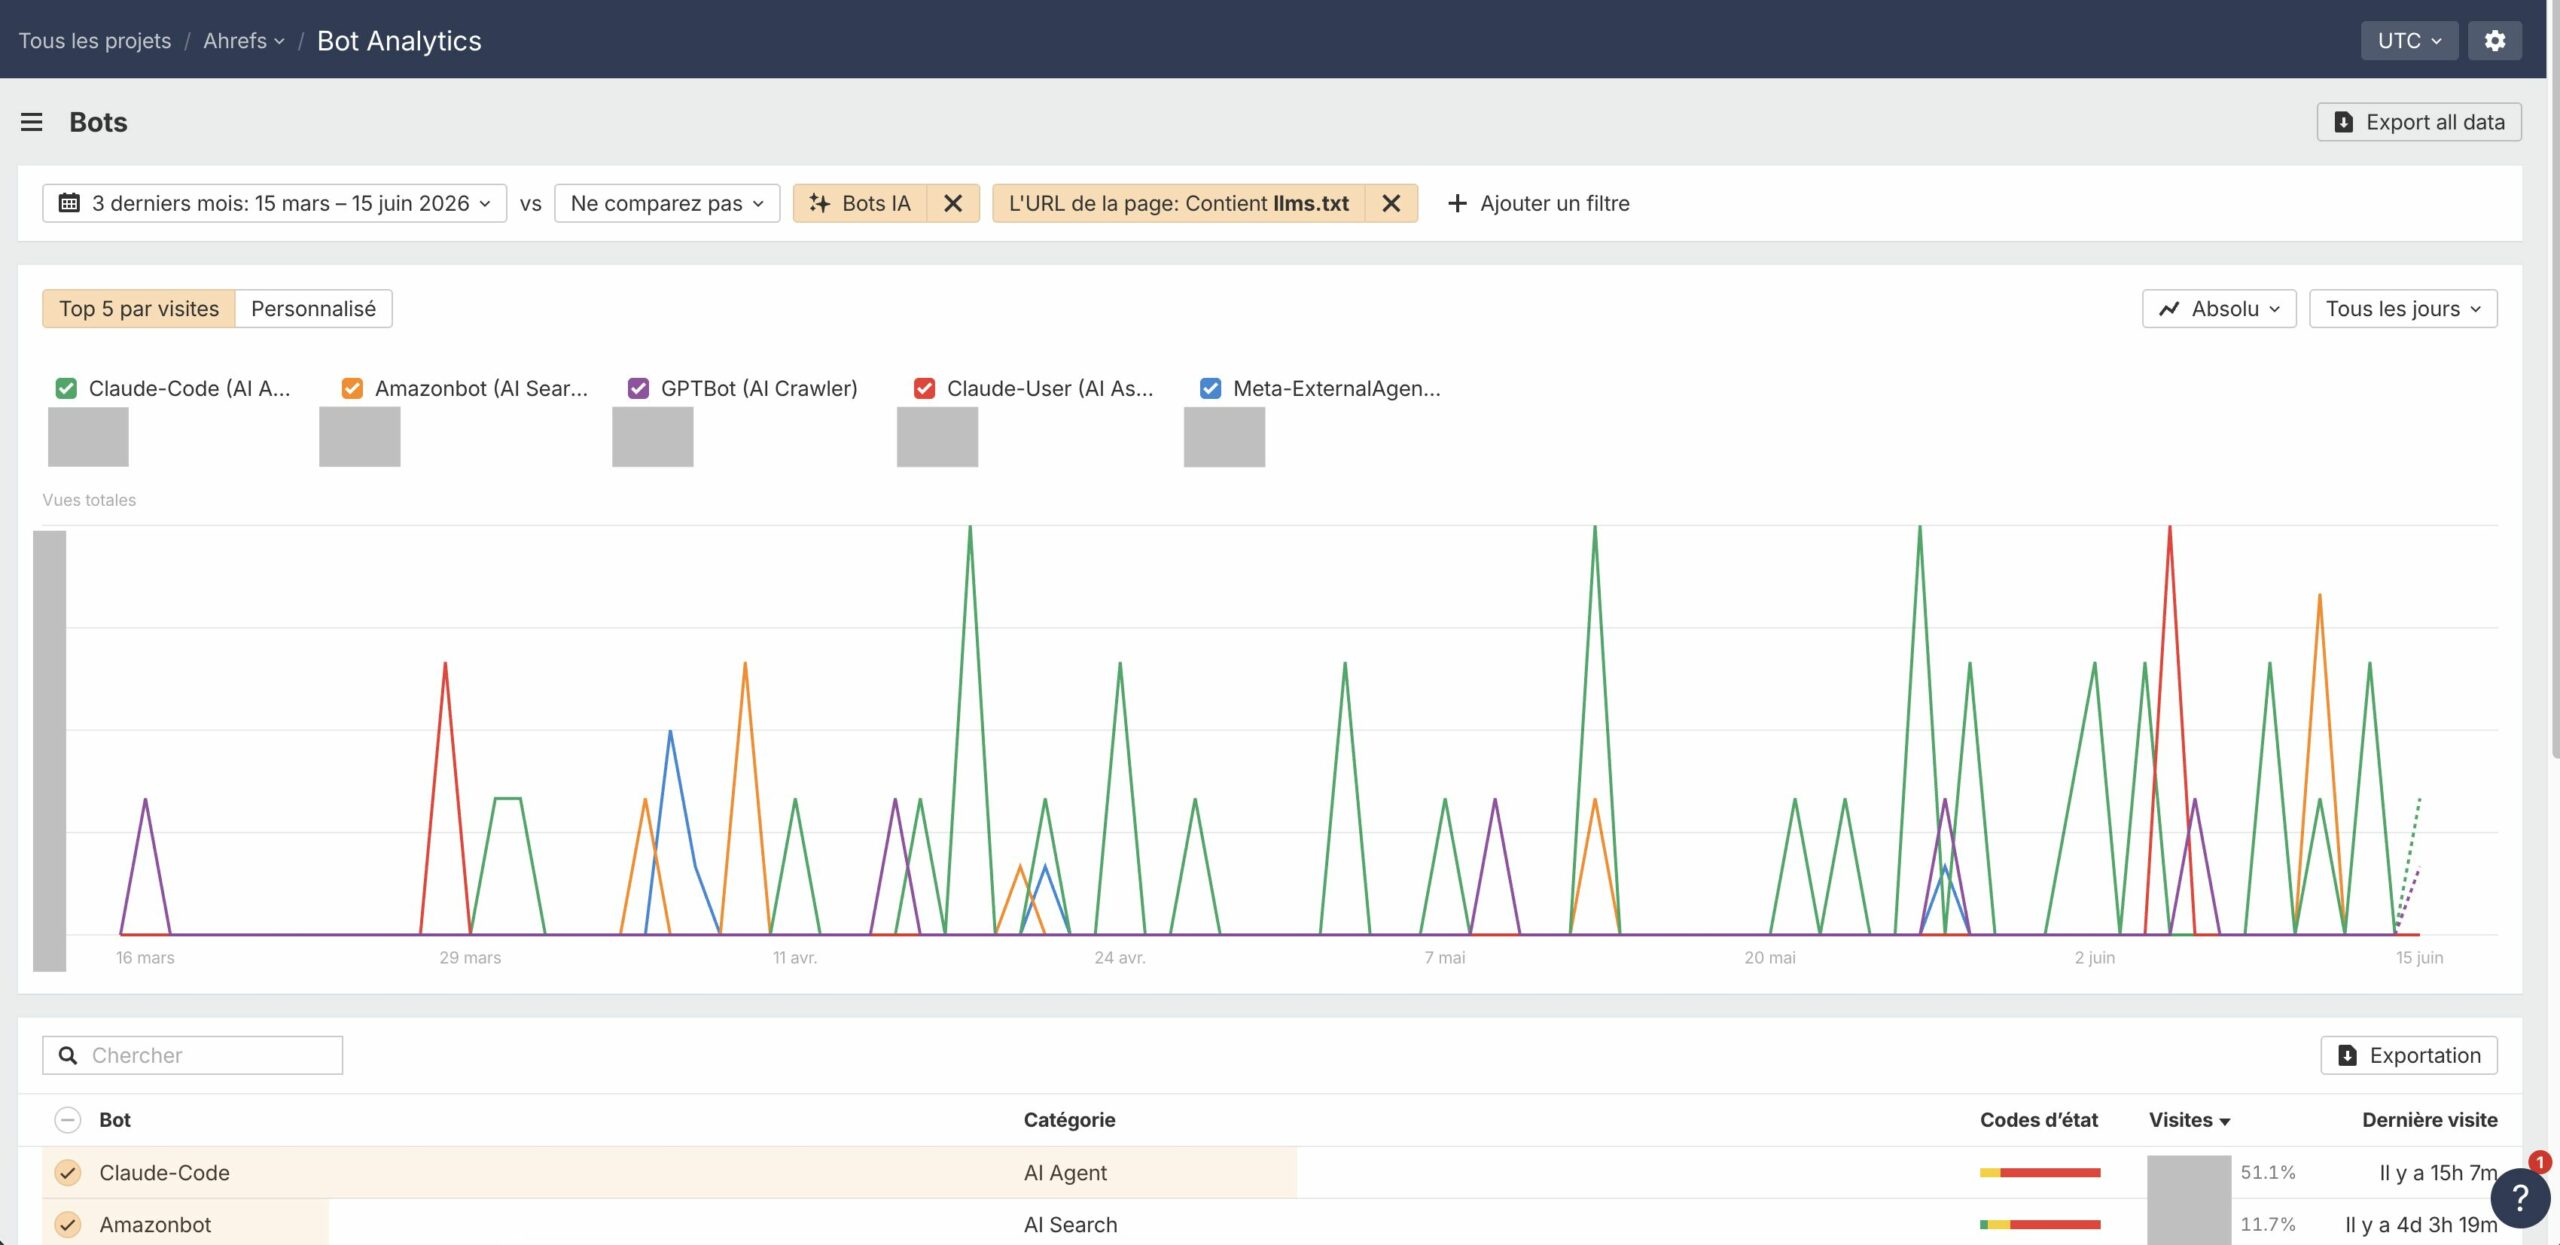
Une commande permet déjà d’obtenir un diagnostic rapide dans les logs serveur :
# Quels bots IA passent, et avec quels codes de réponse ?
grep -E "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|Google-Extended" access.log \
  | awk '{print $9}' | sort | uniq -c | sort -rn
Et là, un détail me saute souvent aux yeux : les 403 et les 429.
Quand ces codes apparaissent, le refus vient souvent du pare-feu applicatif ou d’une limitation de débit.
Le robots.txt autorise donc le crawler… tandis qu’une autre couche technique lui ferme la porte.
C’est discret. Et très fréquent.
Le user-agent suffit-il à prouver qu’un bot est bien GPTBot ?
Réponse : Non, c’est une simple déclaration : il faut croiser l’adresse IP avec les plages officielles. Un script peut écrire GPTBot dans son en-tête. Je croise donc l’IP avec les plages publiées par OpenAI et Perplexity. Pour Anthropic, j’utilise une résolution DNS inverse suivie d’une résolution directe.
La méthode complète, commandes comprises, est dans l’analyse de logs.
11Comment vérifier que la configuration fonctionne ?
Une fois le robots.txt configuré, j’utilise quatre contrôles.
- Le rendu HTML
- Le test en conditions réelles
- Les logs serveur
- Bing Webmaster Tools
1. Le test de rendu
Je vérifie que le contenu susceptible d’être cité apparaît directement dans le HTML initial.
Les Crawlers IA rendent JavaScript avec beaucoup moins d’efficacité que Googlebot lorsqu’un rendu devient nécessaire.
Je peux commencer avec une commande toute simple :
curl -sL -A "OAI-SearchBot" https://votresite.fr/page | grep -i "votre phrase de réponse"
La phrase apparaît ? Très bien. Le crawler reçoit ce contenu.
2. Le test en conditions réelles
Je pose à Perplexity une question à laquelle ma page répond directement.
Puis je regarde les sources citées.
Son indexation rapide et l’affichage très visible des citations rendent ce contrôle particulièrement pratique.
3. Les logs
Je regarde la fréquence de passage de chaque agent et les pages qu’il visite en priorité.
C’est le seul signal propriétaire montrant directement ce que les plateformes viennent consulter sur mon site.
4. Bing Webmaster Tools
Son rapport AI Performance affiche les citations réelles d’un contenu : combien de fois une page a servi de source dans une réponse générée.
Je peux aussi y retrouver les pages citées, l’évolution des citations et certaines grounding queries.
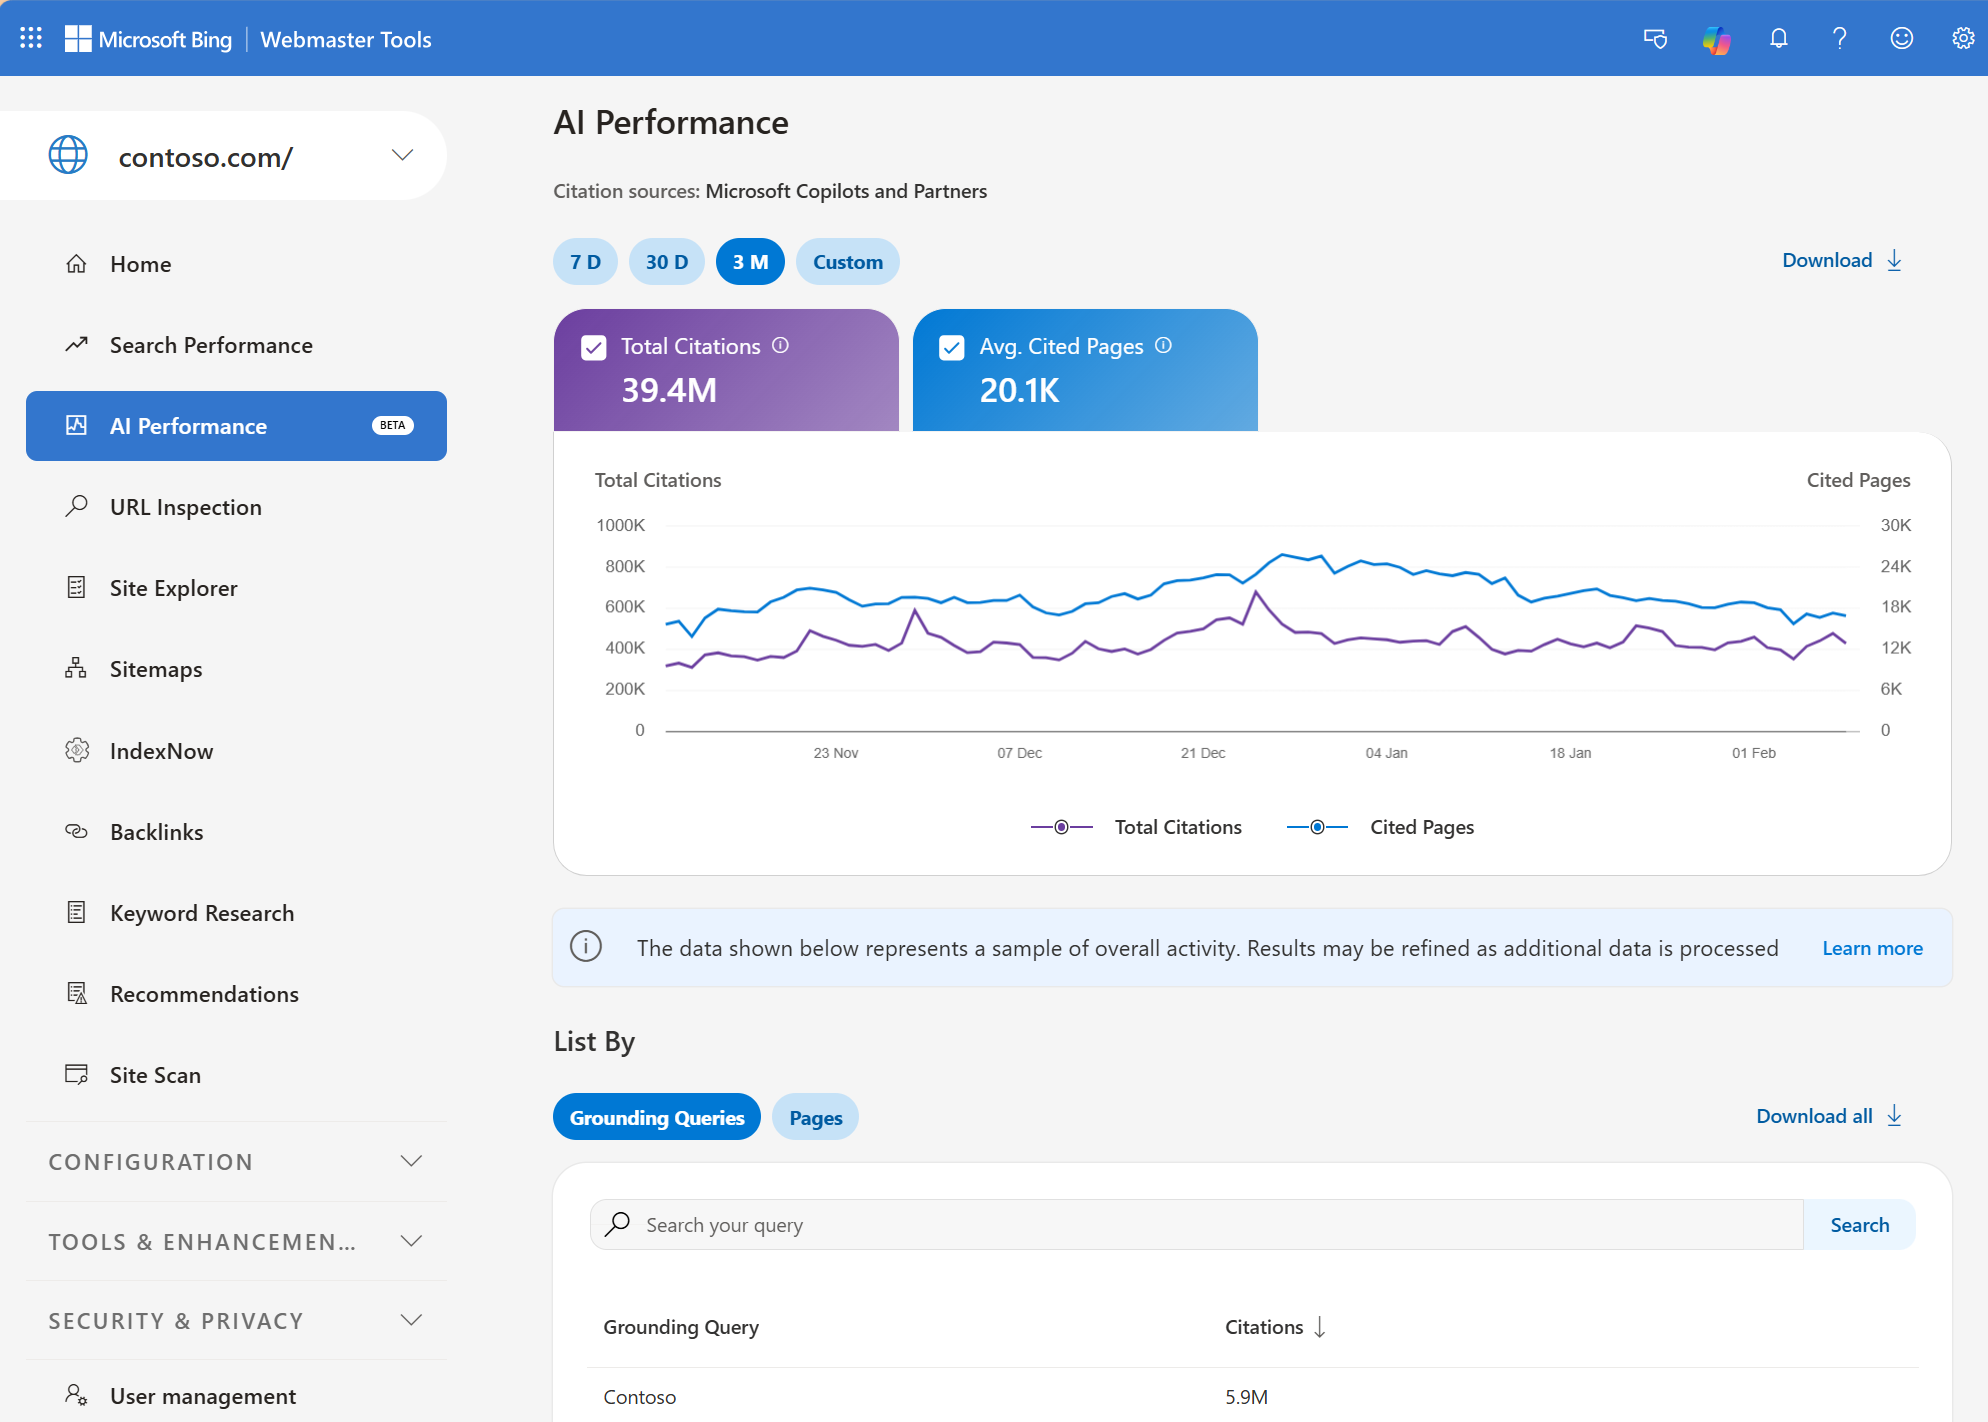
Pour suivre les citations, c’est aujourd’hui l’une des données officielles les plus directement exploitables.
Pour tester vite, lancez un curl avec le user-agent OAI-SearchBot et cherchez une phrase de votre réponse dans le HTML. Si elle n’apparaît pas, le crawler ne la voit pas non plus.
Pourquoi vérifier que le contenu à citer apparaît dans le HTML initial ?
Réponse : Parce que les crawlers IA rendent le JavaScript bien moins efficacement que Googlebot. Si votre phrase de réponse n’apparaît pas dans le HTML reçu par le crawler, il ne la verra tout simplement pas.
Si votre contenu n’apparaît pas dans le HTML initial, la cause est souvent le JavaScript : je l’explique dans SEO JavaScript. Côté Bing, activez IndexNow pour signaler vos mises à jour sans attendre.
Enfin, pour aider les robots à comprendre qui vous êtes, complétez vos données structurées.
- Un crawler IA a trois usages : entraînement, indexation de recherche, récupération à la demande.
- Bloquer OAI-SearchBot sort votre site des réponses issues de la recherche ChatGPT.
- Après une modification du robots.txt, comptez environ 24 heures côté recherche OpenAI.
- Claude-User respecte le robots.txt, alors que ChatGPT-User peut être traité différemment.
- Le user-agent n’est qu’une déclaration : je vérifie l’adresse IP.
- Les crawlers IA rendent le JavaScript moins bien que Googlebot : le contenu à citer doit être dans le HTML initial.
12Sources
- OpenAI, Overview of OpenAI Crawlers, documentation développeurs
- Anthropic, documentation consacrée à
ClaudeBot,Claude-UseretClaude-SearchBot, février 2026 — voir la couverture de Search Engine Land - Google Search Central, Optimizing your website for generative AI features on Google Search, mai 2026, mise à jour le 10 juillet 2026
- Ahrefs, 97 % des fichiers llms.txt ne sont jamais lus, juin 2026
- Seer Interactive, What Drives Brand Mentions in AI Answers?, octobre 2025, sur plus de 360 000 réponses
- Microsoft Bing Webmaster Blog, Introducing AI Performance in Bing Webmaster Tools, 10 février 2026
Bloquer GPTBot m’empêche-t-il d’apparaître dans ChatGPT ?
GPTBot sert à l’entraînement des modèles.
Pour la visibilité dans les réponses issues de la recherche ChatGPT, c’est OAI-SearchBot qui compte.
Je peux donc bloquer GPTBot tout en autorisant OAI-SearchBot.
Mes futurs contenus restent hors des jeux d’entraînement tandis qu’ils restent accessibles à la recherche en temps réel.
Le robots.txt est-il respecté par tous les Crawlers IA ?
Les bots d’entraînement et d’indexation des grands éditeurs respectent le robots.txt.
Pour les agents déclenchés directement par un utilisateur, le fonctionnement diffère.
ChatGPT-Userpeut être traité différemment lorsque la récupération découle d’une action humaineClaude-Userapplique les directives du robots.txt
Combien de temps faut-il pour qu’un changement prenne effet ?
Côté recherche OpenAI, comptez environ 24 heures.
Chez les autres moteurs, le délai varie de quelques heures à plusieurs jours selon leur fréquence de passage.
Et là encore, je reviens aux logs. Ils montrent directement le prochain passage du crawler.
Faut-il ajouter un fichier llms.txt en complément ?
Le fichier llms.txt suscite beaucoup de discussions.
Son usage réel reste pourtant très faible.
Une analyse portant sur environ 137 000 domaines a montré qu’en mai 2026, 97 % des fichiers llms.txt observés avaient reçu zéro requête.
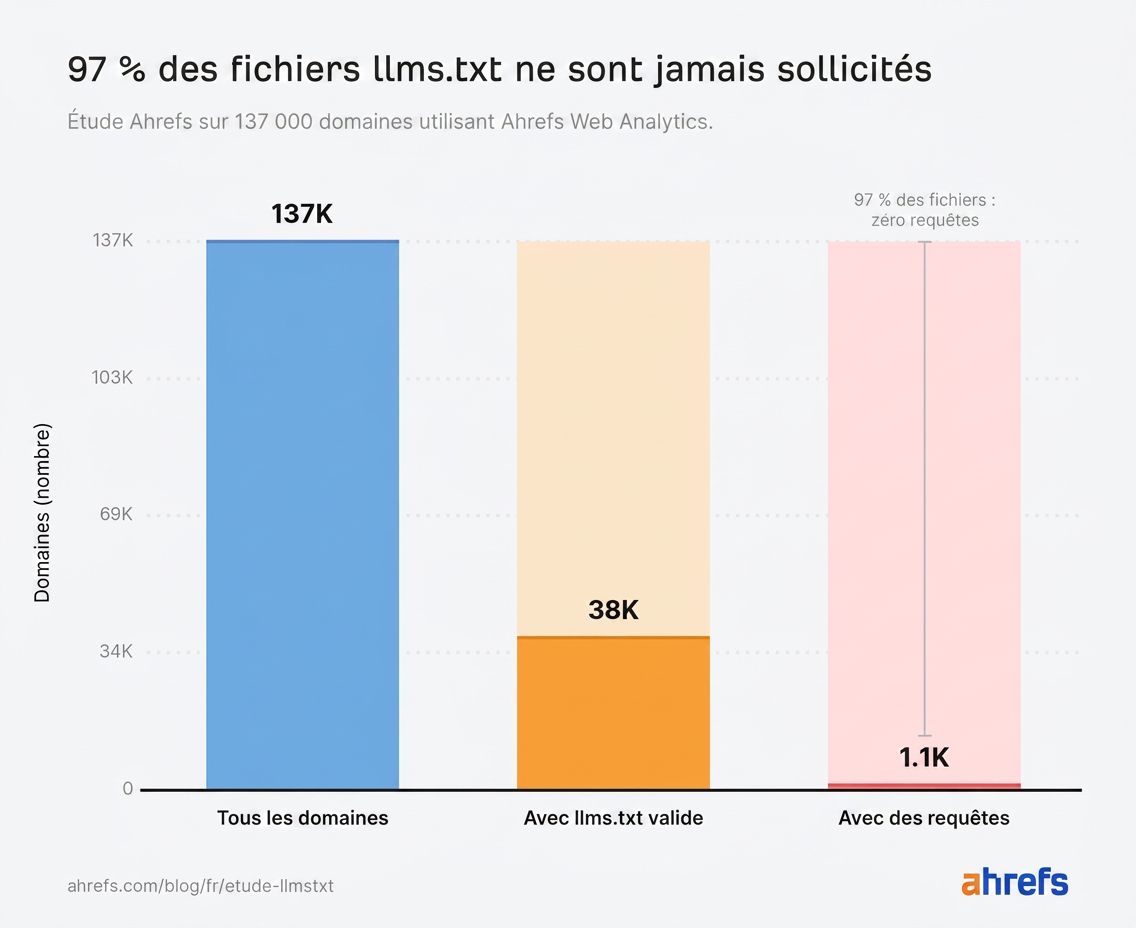
Google indique également que ce fichier est inutile pour apparaître dans ses fonctionnalités génératives.
Pour contrôler l’accès des Crawlers IA, je concentre donc mon attention sur le robots.txt et les user-agents décrits ici.
Comment savoir si mon pare-feu bloque des Crawlers IA ?
Je filtre mes logs sur les user-agents concernés, puis je regarde les codes HTTP retournés.
- Un
403correspond à un accès refusé - Un
429correspond généralement à une limitation du nombre de requêtes
Le robots.txt peut donc accueillir le crawler tandis que le CDN ou le pare-feu le bloque juste derrière.
Les protections anti-bots activées par défaut chez certains hébergeurs et CDN expliquent souvent ce comportement.
Puis-je autoriser certains bots sur une partie du site seulement ?
Oui.
La directive Disallow accepte des chemins différents selon chaque agent.
Je peux donc organiser les accès ainsi :
- Pages éditoriales publiques ouvertes aux crawlers de recherche
- Espaces clients exclus
- Zones payantes exclues
- Pages du tunnel d’achat exclues
Les guides de ce chantier
sur le sujet
Votre message,
en deux minutes.
Remplissez le formulaire : il arrive directement dans ma boîte. Je le lis moi-même et je vous réponds en général le jour même, du lundi au vendredi.
Vous préférez parler ? 06 59 54 68 89, ou un créneau de 15 minutes.
Vos coordonnées servent uniquement à vous répondre. Jamais de newsletter sans votre accord. Détails dans la politique de confidentialité.
Parlons-en ensemble.
Vous avez une question, un projet ?