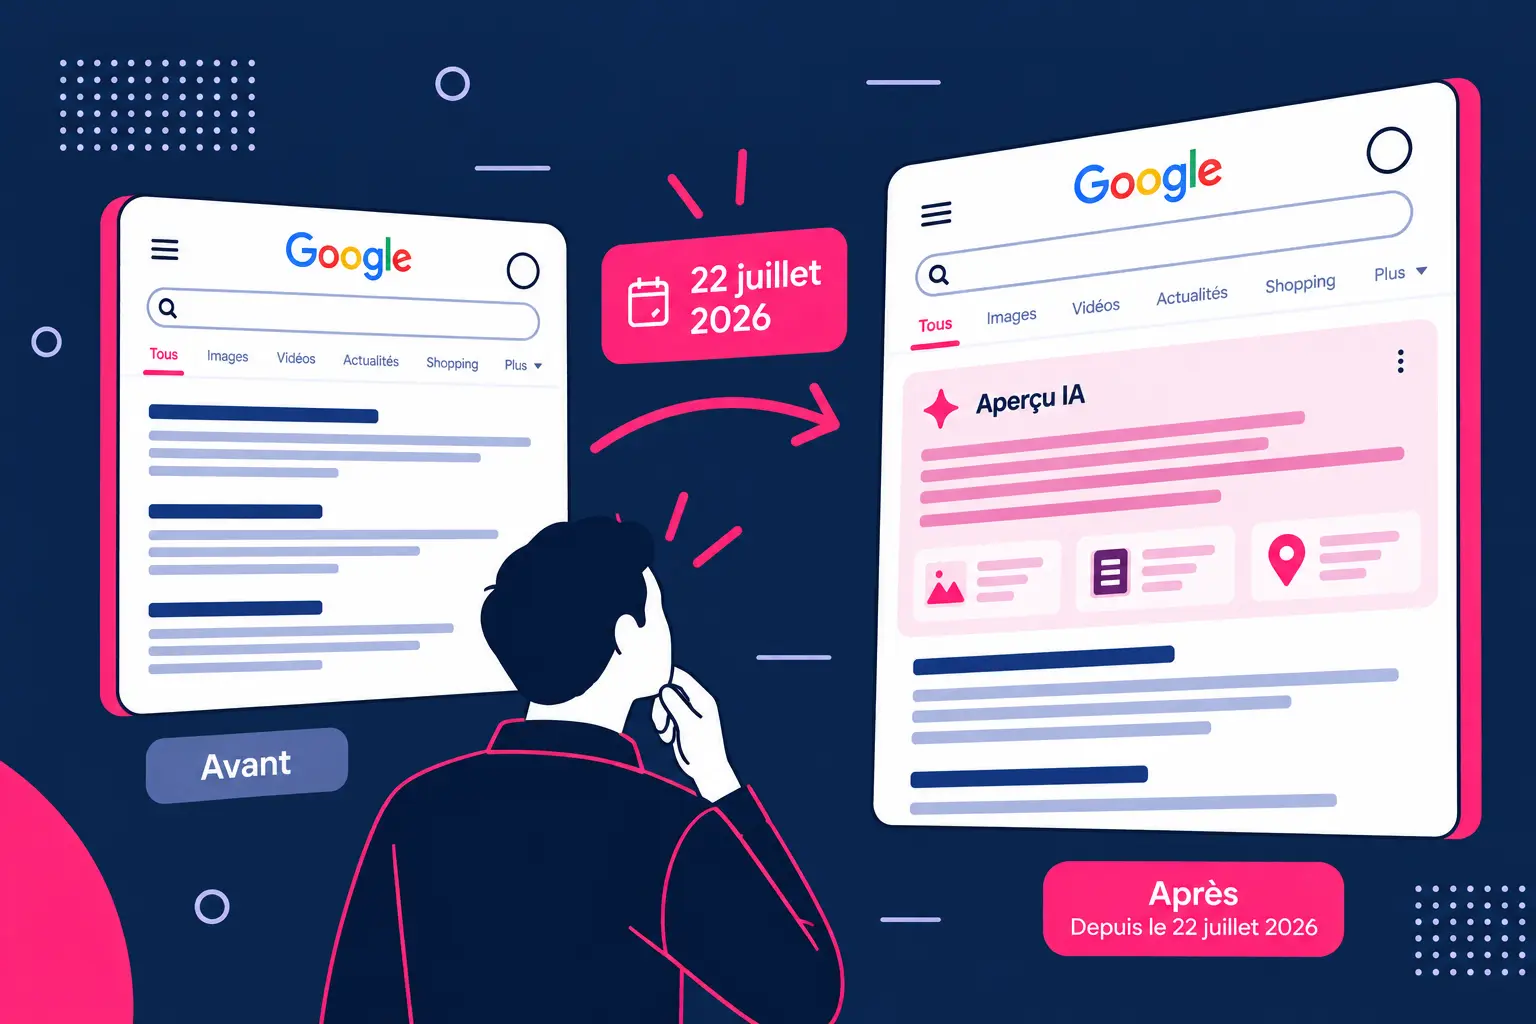

Depuis que les AI Overviews se sont installés dans Google, je vois fleurir les techniques GEO. Des fichiers spéciaux. Des structures pensées pour les IA. Des recettes censées augmenter les citations…
Et puis, en mai 2026, Google publie sa propre documentation consacrée à ses fonctionnalités génératives. Évidemment, je vais voir.
Et là, surprise. Le discours est beaucoup plus simple : le SEO reste au centre du système et plusieurs tactiques estampillées « IA » sont directement classées comme inutiles.
Bon. Ça mérite que je m’y attarde.
Cette page est aussi particulière pour une autre raison : c’est la seule source de première main consacrée au fonctionnement d’une grande surface de recherche générative. Je prends donc ses informations techniques très au sérieux. Ses recommandations, elles, méritent aussi un peu de recul.
Mis à jour le 4 septembre 2026 par Alexandre Montenon, consultant marketing digital à Lyon
Que contient exactement cette documentation ?
Le document s’intitule Optimizing your website for generative AI features on Google Search. Il a été publié en mai 2026, puis mis à jour le 10 juillet 2026.
Google l’a également présenté sur son blog développeurs comme une ressource consolidée. L’objectif : réunir sur une seule page des recommandations jusque-là dispersées.
Jusque-là, très bien. Une nouvelle documentation Google.
Ce qui m’intéresse davantage arrive juste après. Google explique aussi quelles pratiques il juge inutiles.
Et ça, venant de Google, c’est beaucoup plus rare.
Le SEO est-il toujours pertinent ?
La réponse tient en trois mots : « In short, yes! »
Bon. Fin du débat ? Évidemment, le sujet mérite davantage.
L’explication technique qui suit est surtout très importante. Les fonctionnalités génératives de Google restent enracinées dans les systèmes de classement et de qualité du cœur de Search.
Autrement dit, derrière les AI Overviews, je retrouve toujours les grands mécanismes de Google Search. Le système génératif vient s’appuyer dessus.
Et ça entraîne une première conséquence très concrète.
Une page doit être indexée et éligible à un extrait pour pouvoir apparaître dans un Aperçu IA.
Premier filtre : le SEO classique. Une page correctement crawlée, indexée et éligible entre dans la course.
Le classement organique conserve également son importance. Environ 38 % des citations présentes dans les AI Overviews proviennent de pages classées dans le top 10.
Et là, la comparaison avec ChatGPT Search devient intéressante.
Semrush a mesuré que la page citée par ChatGPT se trouve en position 21 ou au-delà dans près de 90 % des cas.
Chez Google, le rang organique conserve donc un poids réel. Chez ChatGPT, la relation devient beaucoup plus faible.
C’est une différence importante. Et, à mon sens, elle disparaît beaucoup trop souvent dans les contenus qui rangent toutes les IA dans une seule grande boîte appelée « GEO ».
Que recommande Google concrètement ?
Google met en avant cinq grands axes.
Et là, je dois reconnaître quelque chose : pour quelqu’un qui pratique déjà le SEO sérieusement, la liste semble très familière.
Premier axe : produire du contenu non-commodité.
Google prend un exemple assez parlant. Un article intitulé « 7 conseils pour un premier achat immobilier » relève de la connaissance commune. Des centaines de sites peuvent produire quasiment le même contenu.
En revanche, raconter pourquoi les auteurs ont renoncé à une inspection, ce que cachait réellement une canalisation et combien cette décision leur a coûté change complètement la donne.
Là, j’ai une expérience réelle. Une information de première main. Quelque chose qui appartient à son auteur.
Ma traduction est simple : un contenu intéressant pour les moteurs génératifs contient quelque chose qu’ils trouveront difficilement ailleurs.
Sinon, pourquoi votre page plutôt qu’une vingtaine d’autres qui racontent exactement la même chose ?
Deuxième axe : soigner la partie technique.
Google revient ici aux fondamentaux : site explorable, indexable, bonnes pratiques JavaScript et bonne expérience de page.
Il glisse aussi une petite remarque : le référencement d’un site construit avec un framework JavaScript devient généralement plus complexe.
Petite phrase. Gros avertissement pour certains projets.
Troisième axe : travailler les images et les vidéos.
Google les traite comme de véritables contenus dans ses surfaces génératives. Elles dépassent donc largement leur fonction décorative.
Quatrième axe : réduire le contenu dupliqué.
Là encore, grand classique du SEO. Sauf que l’enjeu prend une autre dimension avec les systèmes génératifs.
Des contenus très proches peuvent diluer les signaux associés à une entité. Or la résolution et la compréhension des entités prennent justement de plus en plus de poids.
Cinquième axe : tenir à jour ses fiches commerciales et locales.
Merchant Center et Google Business Profile alimentent directement certaines réponses liées aux achats et aux recherches de proximité.
Pour un commerce, c’est souvent l’un des leviers les plus rentables. Et aussi l’un des plus sous-exploités.
Que dit Google d’ignorer ?
Alors là, j’arrive à ma partie préférée.
Parce que Google vient directement contredire plusieurs pratiques aujourd’hui vendues comme incontournables dans le GEO.
| Tactique | Position de Google |
|---|---|
Fichiers llms.txt et autres marquages « spéciaux » pour l’IA | Ses systèmes ne les utilisent actuellement pas |
| Découpage artificiel du contenu en petits blocs | Ses systèmes comprennent plusieurs sujets sur une même page |
| Réécriture du contenu spécialement pour l’IA | Google continue de privilégier une rédaction destinée aux humains |
| Recherche artificielle de mentions | Google les considère comme inefficaces et contraires à ses politiques anti-spam |
| Surinvestissement dans les données structurées | Elles restent facultatives pour la recherche générative et aucun schema dédié à l’IA n’existe |
Le cas de llms.txt m’intéresse particulièrement.
Une analyse d’Ahrefs portant sur 137 210 domaines montre qu’en mai 2026, environ 38 000 sites disposaient d’un fichier valide.
Et parmi eux ? 97 % de ces fichiers avaient reçu zéro requête.
Autant dire que l’adoption existe davantage du côté des éditeurs que du côté des machines censées les consulter.
John Mueller avance aussi un argument que je trouve intéressant. Un llms.txt reste une information déclarée par le site lui-même.
En gros : « voici ce que vous devez savoir sur moi ». Très bien. Mais pour départager deux sites concurrents, la valeur du signal reste forcément limitée.
Google tranche également le débat sémantique autour de l’AEO et du GEO.
Pour lui, optimiser un site pour la recherche générative revient à optimiser l’expérience de recherche. Donc à faire du SEO.
Le moteur renvoie d’ailleurs directement vers sa page consacrée à l’évaluation des conseils SEO proposés par des tiers.
Comment mesurer sa présence, selon Google ?
Pour mesurer la visibilité dans les AI Overviews, Google recommande évidemment… Google.
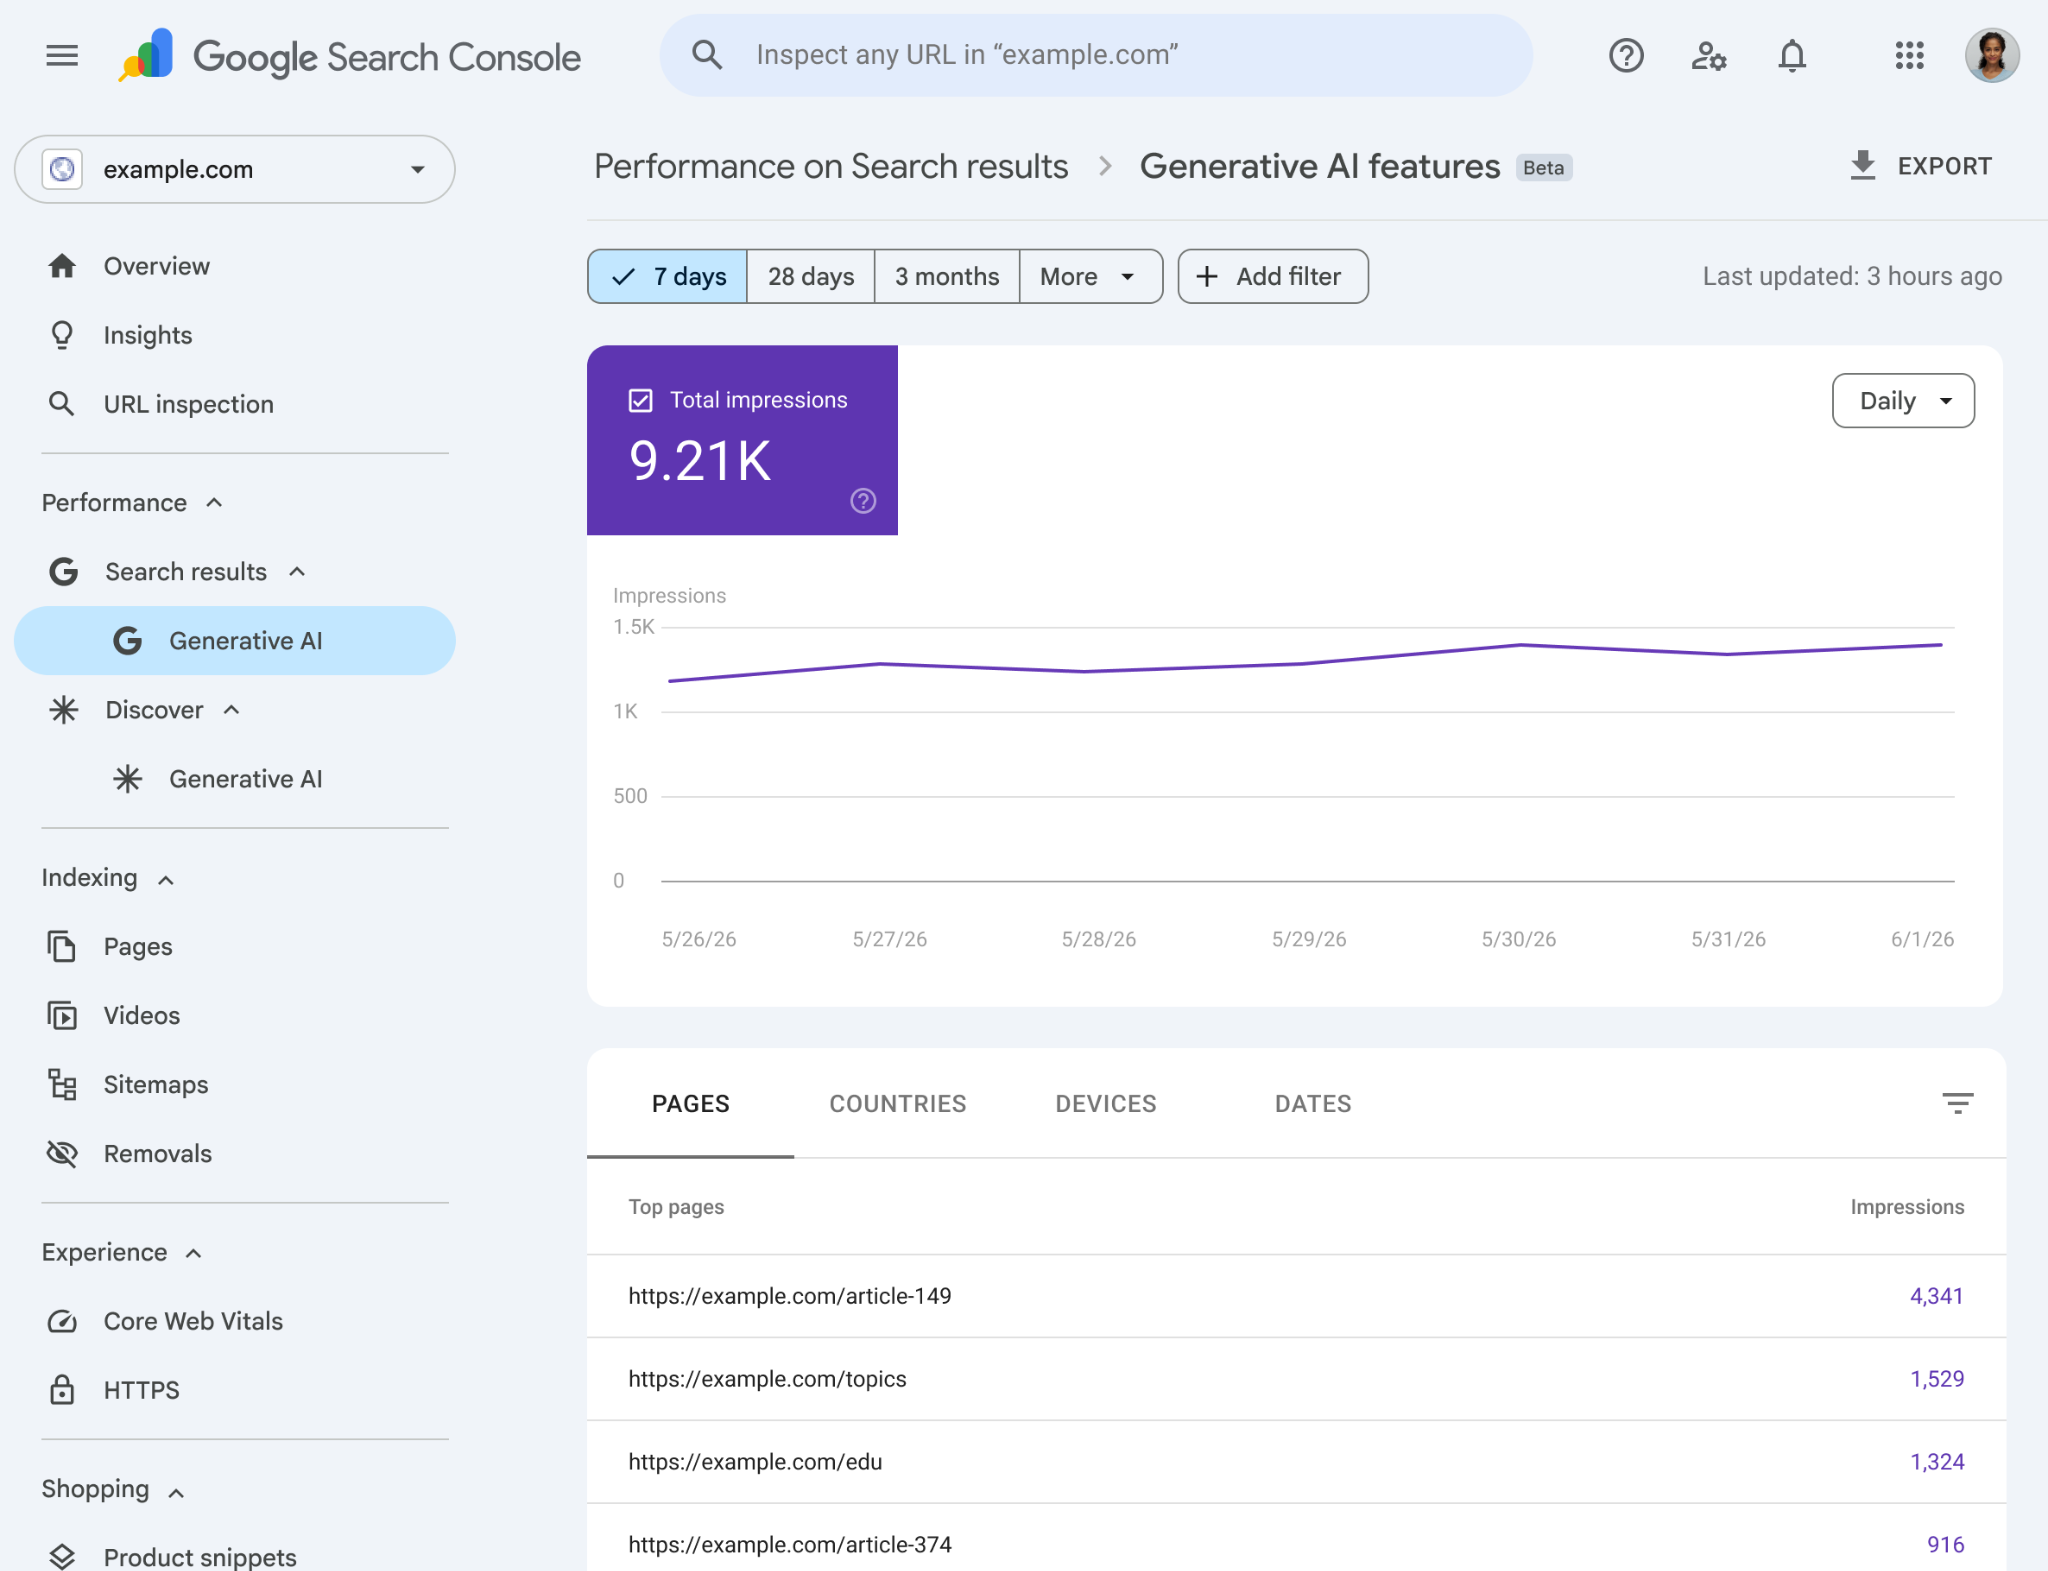
Depuis le 3 juin 2026, son rapport « IA générative » dans la Search Console permet d’isoler les impressions liées aux Aperçus IA, au Mode IA et à Discover.
Google ajoute ensuite une mise en garde que je trouve plutôt saine : prudence avec les outils tiers qui annoncent le « succès » ou évoquent des métriques internes de Google.
Un outil externe observe les réponses générées. Il échantillonne. Il mesure. Il compare.
Mais il regarde le moteur depuis l’extérieur.
Là où je trouve la situation assez amusante, c’est que l’outil de Google reste lui-même beaucoup moins riche que celui de son concurrent Microsoft.
Le rapport AI Performance de Bing Webmaster Tools fournit des citations réelles. Je peux y retrouver les URL utilisées comme sources, leur activité de citation et les requêtes de grounding formulées par le système.

La Search Console reste plus limitée.
Des impressions, oui. Des clics, du CTR, les requêtes ou une distinction précise entre AI Overviews et Mode IA ? Ces données restent hors du rapport.
Pour une analyse fine, j’ai donc rapidement envie d’aller voir ailleurs.
Ce que cette documentation ne dit pas
C’est ici que je quitte le simple résumé.
Parce que le document dit beaucoup de choses intéressantes. Mais il laisse aussi plusieurs sujets importants sur le bord de la route.
Premier point : il concerne uniquement Google.
Ça paraît évident. Pourtant, cette précision change énormément de choses.
ChatGPT, Perplexity et Claude reposent sur des mécaniques différentes : index propre ou partenaire, poids beaucoup plus faible du classement Google, sensibilité supérieure à la fraîcheur…
Du coup, appliquer directement la doctrine Google à tous les moteurs génératifs crée de sérieux angles morts.
Deuxième point : les signaux hors-site occupent très peu de place.
Les mentions de marque, l’earned media, les plateformes d’avis ou encore YouTube restent quasiment absents du document.
Pourtant, les données disponibles les placent parmi les signaux les plus corrélés à la visibilité IA.
Sur 75 000 marques analysées, les mentions YouTube atteignent environ 0,737 de corrélation. Les mentions web de marque se situent entre 0,66 et 0,71.
Les backlinks ? Environ 0,218.
Ah. Là, le tableau devient déjà un peu différent.
Google documente avant tout son propre environnement. Je garde simplement cette limite en tête lorsque je lis ses recommandations.
Troisième point : la sélection des sources reste largement mystérieuse.
Pourquoi une page précise apparaît-elle dans un Aperçu IA plutôt qu’une autre lorsque les deux affichent une qualité et un classement comparables ?
La documentation décrit surtout les conditions d’éligibilité. Elle entre beaucoup moins dans le mécanisme de sélection.
Quatrième point : le trafic.
Google explique comment gagner en visibilité dans ses surfaces génératives. Sur ce que cette visibilité rapporte réellement en visites, le discours devient beaucoup plus discret.
Et c’est assez cohérent avec son propre rapport de mesure, largement centré sur les impressions.
Dernier point : les données structurées.
Et là, j’ai un petit problème.
Google explique qu’elles restent facultatives pour la recherche générative. Pourtant, deux analyses indépendantes racontent une histoire un peu plus nuancée.
Le papier GEO-16, basé sur 1 702 citations, place les données structurées parmi les trois familles de signaux les plus prédictives d’une citation.
De son côté, Semrush observe davantage de données structurées sur les pages citées que sur la moyenne des pages étudiées.
Le schema Organization apparaît sur 34 % des pages citées en Mode IA. Le schema Article atteint 26 %.
Alors, Google raconte-t-il autre chose que ce que montrent les études ? Je lis plutôt les données différemment.
Pour moi, les données structurées sont surtout un marqueur davantage qu’un levier direct.
Un site qui les utilise correctement est souvent bien tenu techniquement. Elles facilitent aussi la compréhension de l’entité.
En revanche, leur simple présence suffit difficilement à déclencher une citation.
Je continue donc à les déployer lorsqu’elles sont pertinentes. Leur coût reste faible et leur utilité dépasse largement les AI Overviews.
J’évite simplement de leur attribuer un pouvoir magique.
Comment lire ce document de façon critique ?
De mon côté, j’applique trois réflexes.
Premier réflexe : distinguer la description de la prescription.
Lorsque Google décrit son architecture, son index ou les conditions d’éligibilité à un extrait, j’écoute attentivement. Après tout, il décrit son propre moteur.
Lorsque Google recommande un comportement, je garde davantage de recul.
Le moteur conseille alors les éditeurs. Et, forcément, il défend aussi le fonctionnement de son propre écosystème.
Deuxième réflexe : garder en tête l’intérêt de Google à limiter une industrie parallèle.
Un marché entier consacré au « GEO hacking », c’est aussi une multiplication des techniques adverses à détecter et à encadrer.
Dans ce contexte, présenter la recherche générative comme une continuité du SEO reste à la fois techniquement défendable et plutôt confortable pour Google.
Troisième réflexe : distinguer « c’est toujours du SEO » de « le fonctionnement reste identique ».
Les leviers peuvent rester proches. Les objectifs, eux, évoluent.
Une action SEO peut désormais conduire à une citation dans une réponse générative plutôt qu’à un clic classique.
Une mention de marque peut également prendre davantage de valeur qu’une visite supplémentaire.
Autrement dit, la méthode peut rester familière tandis que le KPI change.
Et c’est exactement pour cette raison qu’une progression de la visibilité IA peut très bien coïncider avec une baisse du trafic organique.
Que retenir en pratique ?
- Continuez à faire du SEO propre. C’est la condition d’entrée dans les surfaces génératives de Google
- Laissez de côté
llms.txtet les optimisations « spéciales IA » pour Google. Les données disponibles vont dans le même sens que la position officielle - Investissez dans le contenu non-commodité. Expériences, données internes, observations terrain et informations spécifiques créent une vraie différence
- Déployez les données structurées avec mesure. Je les considère surtout comme un marqueur d’entité et de qualité technique
- Complétez la Search Console avec Bing Webmaster Tools. Microsoft fournit aujourd’hui des données de citation beaucoup plus détaillées gratuitement
- Réservez cette doctrine à Google. ChatGPT, Perplexity et Claude reposent sur des mécaniques différentes
Questions fréquentes
Faut-il une stratégie séparée pour les AI Overviews ?
Pour Google, les fonctionnalités génératives s’appuient sur l’index et les systèmes de classement de Search. Une page indexée et éligible à un extrait peut donc apparaître dans les Aperçus IA avec les fondamentaux habituels du SEO.
ChatGPT, Perplexity et Claude fonctionnent autrement. Leur visibilité mérite donc une approche distincte.
Google utilise-t-il un schema.org spécifique pour l’IA ?
Google utilise les données structurées classiques et dispose aujourd’hui de zéro balisage dédié à ses fonctionnalités génératives.
Elles restent utiles pour les contenus enrichis et pour faciliter la compréhension d’une entité. Google les considère toutefois comme facultatives pour apparaître dans ses fonctionnalités génératives.
Le fichier llms.txt sert-il à quelque chose pour Google ?
Google indique ne pas l’utiliser. L’analyse d’Ahrefs menée sur 137 210 domaines montre également que 97 % des fichiers existants avaient reçu zéro requête en mai 2026.
Son cas d’usage documenté concerne surtout la documentation technique consommée par certains assistants de code.
Faut-il découper ses articles en petits blocs pour l’IA ?
Google considère ce découpage artificiel comme inutile. Ses systèmes savent traiter plusieurs sujets sur une même page.
Une structure éditoriale claire pour le lecteur — un titre, une question, une réponse directe — produit déjà naturellement des blocs faciles à exploiter.
Où mesurer sa visibilité dans les Aperçus IA ?
Le rapport « IA générative » de la Search Console fournit des impressions par page, pays et appareil depuis juin 2026.
Le rapport AI Performance de Bing Webmaster Tools va plus loin avec des citations réelles et des requêtes de grounding.
Sources
- Google Search Central, Optimizing your website for generative AI features on Google Search, mai 2026, mis à jour le 10 juillet 2026
- Google Search Central Blog, A new resource for optimizing your website for AI features, mai 2026
- Ahrefs, We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read, juin 2026
- Ahrefs, Top Brand Visibility Factors in ChatGPT, AI Mode, and AI Overviews, 75 000 marques, décembre 2025, mis à jour août 2026
- Semrush, How Do Technical SEO Factors Impact AI Search?, janvier 2026, 5 millions d’URL
- Kumar, A. & Palkhouski, L., AI Answer Engine Citation Behavior: An Empirical Analysis of the GEO-16 Framework, UC Berkeley / Hearst Lab, 2025
- Search Engine Journal, Google’s Mueller Says llms.txt Can’t Help LLMs Differentiate Sites, juin 2026