
Quand on me demande s’il faut bloquer GPTBot, j’ai toujours envie de répondre par une autre question.
Votre contenu, vous le vendez ? Ou vous vous en servez pour vendre autre chose ?
Ça change tout.
Un média vit de ses articles. Son contenu constitue directement sa valeur. Une entreprise de services, elle, publie surtout pour être trouvée, comprise, citée et choisie.
Et là, forcément, bloquer GPTBot produit deux effets très différents.
Entre les deux, il existe aussi une solution que je trouve beaucoup plus intéressante : ouvrir certaines parties du site aux robots d’OpenAI et protéger uniquement les zones sensibles.
Par Alexandre Montenon, consultant GEO à Lyon
Avant de bloquer GPTBot, je regarde quel robot travaille vraiment
Premier piège : mettre tous les robots d’OpenAI dans le même sac.
GPTBot, OAI-SearchBot, ChatGPT-User… Au premier coup d’œil, tout ça ressemble à une petite famille de crawlers qui font plus ou moins la même chose.
Eh bien, justement. Leur fonction change complètement.
OpenAI distingue plusieurs robots :
| Robot | Ce qu’il fait | Effet du blocage |
|---|---|---|
GPTBot | Collecte des contenus pour l’entraînement de futurs modèles | Vos futurs contenus sortent des futures collectes d’entraînement |
OAI-SearchBot | Indexation destinée à la recherche ChatGPT | Vos pages sortent des réponses issues de la recherche ChatGPT |
ChatGPT-User | Récupération d’une page demandée directement par un utilisateur | La récupération à la demande suit un fonctionnement distinct |
OAI-AdsBot | Vérification des pages d’atterrissage publicitaires | Usage publicitaire uniquement |
Vous voyez le problème ?
Une entreprise qui veut uniquement bloquer GPTBot pour limiter l’utilisation de ses contenus dans l’entraînement peut très bien conserver OAI-SearchBot ouvert.
Or, en 2024, beaucoup d’entreprises ont appliqué des blocages beaucoup plus larges. L’idée semblait logique : OpenAI collecte mes contenus, donc je ferme.
Quelques lignes ajoutées dans le robots.txt. Fin de l’histoire.
Sauf que ces lignes pouvaient aussi couper l’accès à la recherche ChatGPT.
Et le plus gênant arrive ensuite : cette configuration vit sa vie. Trois mois. Un an. Deux ans. Plus personne ne sait vraiment qui l’a ajoutée ni pourquoi.
💡 Mon réflexe : avant toute discussion sur le fait de bloquer GPTBot, je vais voir le robots.txt. Très souvent, je découvre une configuration héritée d’anciennes recommandations plutôt qu’une vraie décision stratégique.
📌 À compléter avec mon vécu : un cas client où un blocage global avait été ajouté « par prudence », sa durée et la réaction du client au moment de comprendre ses conséquences.
Ce que vous perdez quand vous choisissez de bloquer GPTBot
C’est ici que le sujet devient vraiment intéressant.
Car en bloquant l’entraînement, vous protégez quelque chose. Oui.
Mais vous renoncez aussi à autre chose.
Votre marque entre moins dans la mémoire du modèle
Quand j’utilise ChatGPT, je vois deux grandes situations.
Parfois, le système cherche sur le web. Il récupère des sources, construit sa réponse et affiche éventuellement des liens.
Et parfois, il répond directement depuis ce qu’il a appris.
Demandez-lui par exemple quelles solutions existent dans un secteur, quelles marques sont connues ou quels acteurs proposent tel service. Une partie de la réponse peut venir directement de sa mémoire.
Dans ce cas, la connaissance préalable de votre marque devient très importante.
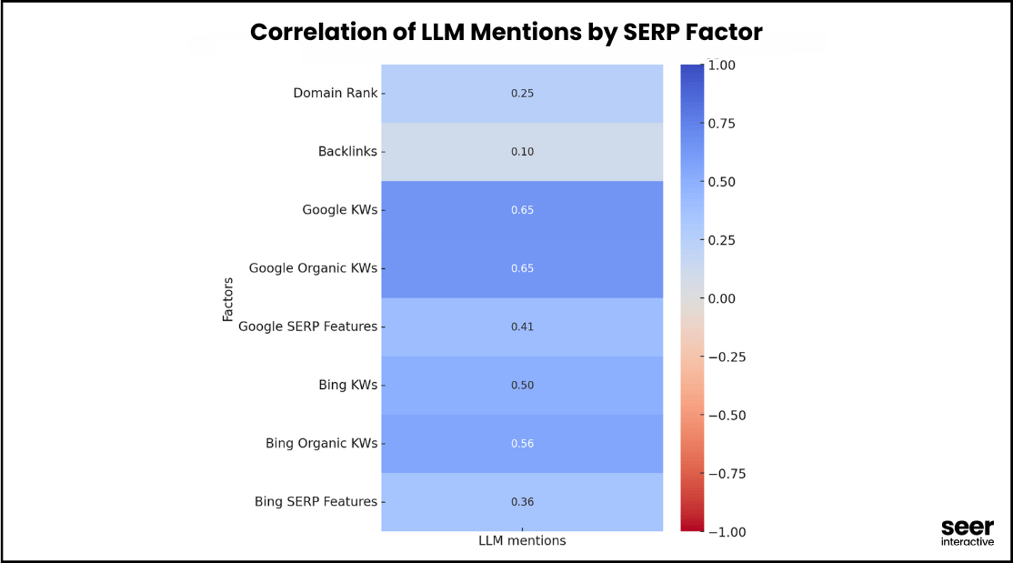
Une analyse portant sur plus de 360 000 réponses avance d’ailleurs une hypothèse que je trouve particulièrement intéressante : le modèle sélectionnerait d’abord les marques qu’il connaît, puis chercherait des sources capables d’appuyer cette sélection.
Autrement dit, la citation arriverait après.
Le choix de la marque, lui, pourrait intervenir avant.
Et là, bloquer GPTBot prend une autre dimension. Vous limitez aussi votre présence dans la matière qui peut servir à construire cette connaissance.
Votre entité devient moins documentée
Deuxième sujet : les modèles raisonnent beaucoup autour des entités.
Une entreprise. Une personne. Un produit. Un lieu. Un service.
Plus les informations disponibles autour de votre marque sont cohérentes, plus le modèle dispose de matière pour comprendre qui vous êtes, ce que vous faites et avec quels sujets vous associer.
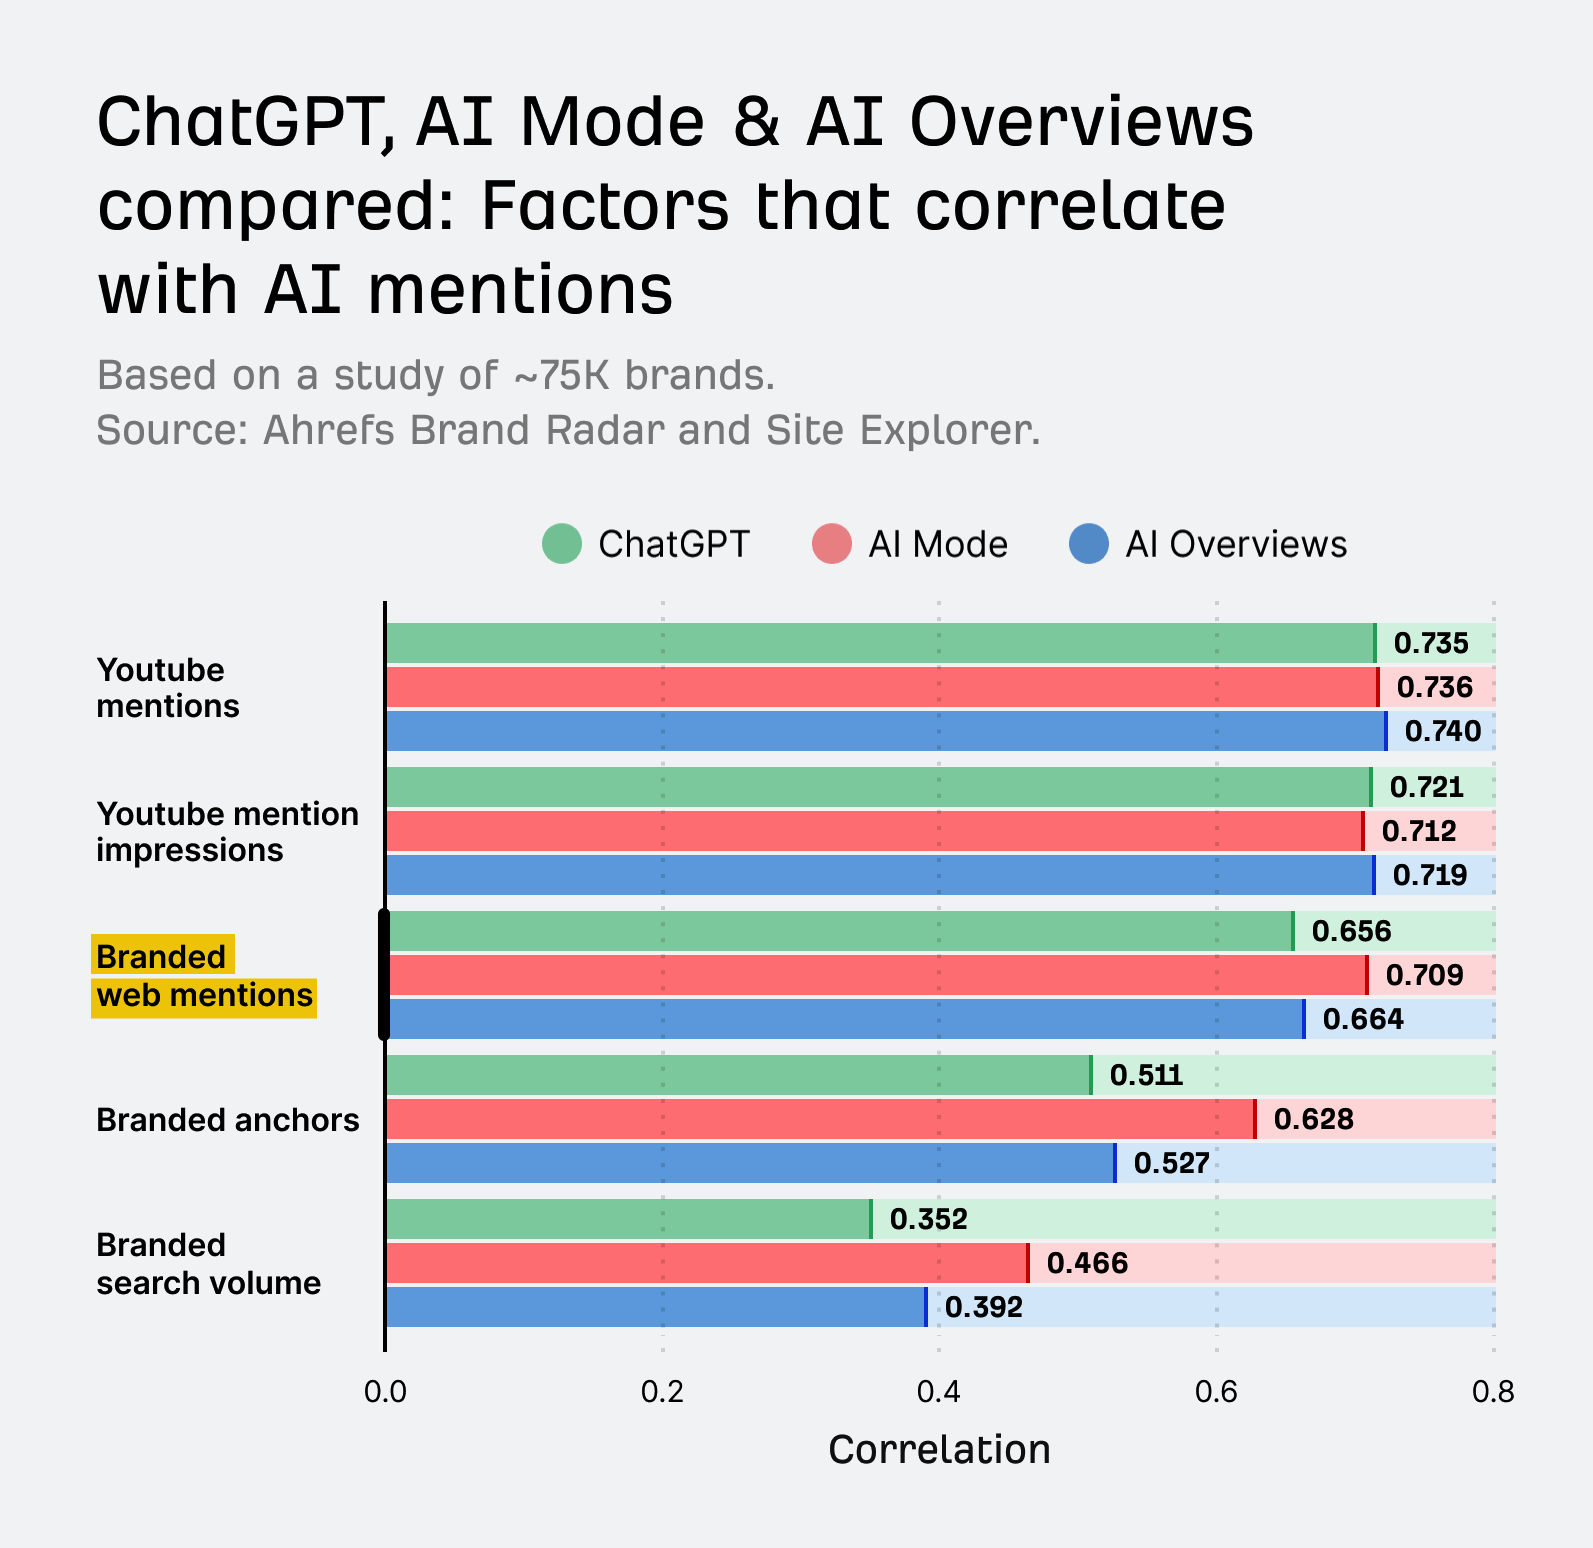
Les travaux d’Ahrefs sur la visibilité des marques dans les moteurs IA montrent justement une forte relation entre les mentions de marque sur le web et leur présence dans les réponses générées.
Ça me paraît assez logique.
Une marque citée, documentée et reliée à son univers sémantique laisse davantage de traces.
Vous perdez aussi une partie de l’antériorité
Chaque génération de modèle absorbe un nouvel instantané du web.
Votre marque apparaît dans plusieurs générations successives ? Sa présence se consolide progressivement.
Vous fermez l’accès pendant une période ? Les futures collectes disposent alors d’une matière différente.
C’est cette continuité qui m’intéresse. La visibilité IA se construit aussi dans le temps.
Ce que vous gagnez en choisissant de bloquer GPTBot
À ce stade, vous pourriez croire que ma conclusion est déjà écrite.
Elle l’est beaucoup moins qu’elle en a l’air.
Car certaines entreprises ont de très bonnes raisons de bloquer GPTBot.
Vous protégez un actif éditorial
Prenons un média.
Son article génère de l’audience. Cette audience finance son modèle économique via l’abonnement, la publicité ou les deux.
Son contenu représente donc directement ce qu’il commercialise.
Dans ce contexte, laisser un modèle absorber gratuitement cette matière crée un véritable sujet économique.
Je comprends donc parfaitement le choix d’un éditeur qui ferme GPTBot.
Vous conservez un levier de négociation
En France, le débat possède aussi une dimension juridique.
Les droits voisins existent depuis 2019. Google a reçu une sanction de 250 millions d’euros de l’Autorité de la concurrence en mars 2024 sur ce dossier.
Puis, fin juin 2026, un accord a précédé le lancement des Aperçus IA en France le 22 juillet 2026.
Pour un éditeur, autoriser ou fermer un robot dépasse donc largement le petit réglage technique.
L’accès à son contenu peut devenir une monnaie de négociation.
Vous protégez aussi certains contenus substituables
Là, je pense surtout aux documentations techniques, aux bases de connaissances et aux contenus méthodologiques très détaillés.
Une entreprise publie toute sa méthode. Étape par étape. Avec ses procédures, ses modèles, ses tableaux et ses explications.
Le modèle dispose alors d’une matière qui peut reproduire une partie de la valeur vendue.
Pour un éditeur de logiciel ou un organisme de formation, cette question mérite donc un vrai arbitrage.
Le blocage de GPTBot possède plusieurs limites
C’est probablement la partie que je trouve la plus utile.
Parce que « bloquer GPTBot » donne facilement l’impression d’ériger une grande barrière autour de ses contenus.
La réalité est beaucoup plus précise.
Le blocage concerne les futures collectes
Vous ajoutez aujourd’hui une règle dans votre robots.txt ? Elle agit sur les futures collectes.
Les données déjà intégrées dans des modèles entraînés restent dans ces modèles.
Une entreprise ouverte depuis plusieurs années protège donc surtout ses prochaines publications.
GPTBot concerne uniquement OpenAI
Autre point souvent oublié : GPTBot représente un robot parmi beaucoup d’autres.
D’autres entreprises disposent de leurs propres crawlers. Des agrégateurs constituent aussi des archives susceptibles d’alimenter différents corpus.
Une vraie politique de protection mérite donc une vision plus large que le seul robot d’OpenAI.
ChatGPT-User fonctionne différemment
Vous copiez une URL dans ChatGPT et demandez au système de lire la page ? Là, un autre mécanisme entre en scène.
ChatGPT-User intervient dans le cadre d’une demande initiée par l’utilisateur.
Ce fonctionnement diffère donc de la collecte réalisée par GPTBot pour l’entraînement.
OAI-SearchBot reste indépendant
Et voici le point qui change souvent complètement la discussion.
Vous pouvez bloquer GPTBot et laisser OAI-SearchBot ouvert.
Vous séparez alors deux usages : l’entraînement futur d’un côté, la recherche ChatGPT de l’autre.
C’est exactement pour cette raison que je regarde chaque user-agent séparément avant de modifier un robots.txt.
💡 Mon conseil : si votre objectif concerne surtout le trafic, travaillez aussi des contenus qui donnent envie de visiter le site. Outils interactifs, données actualisées, comparaisons personnalisées ou fonctionnalités pratiques créent une vraie valeur au-delà d’un texte repris dans une réponse IA.
Les quatre situations que je rencontre
Bon. Maintenant que tout ça est posé, comment choisir ?
Je distingue quatre grands profils.
| Profil | Position que je privilégie | Pourquoi |
|---|---|---|
| Éditeur de presse | Bloquer GPTBot, autoriser OAI-SearchBot | Le contenu constitue directement le produit et les droits voisins entrent dans l’équation |
| Marque produit ou service | Autoriser les robots concernés | Le contenu sert principalement la découverte, la marque et la recommandation |
| Contenu premium ou payant | Autoriser les pages publiques et protéger les zones payantes | L’approche hybride sépare visibilité et contenu substituable |
| Éditeur de logiciel ou organisme de formation | Arbitrer zone par zone | La documentation favorise la découverte tout en concentrant parfois une forte valeur méthodologique |
Le troisième cas, je l’aime particulièrement.
Pourquoi ? Parce qu’il évite le choix tout blanc ou tout noir.
Le robots.txt accepte des règles par chemin. Vous pouvez donc laisser GPTBot accéder au blog, aux pages services et à la présentation de votre entreprise, puis fermer votre documentation la plus sensible.
User-agent: GPTBot
Allow: /blog/
Allow: /solutions/
Allow: /a-propos/
Disallow: /base-de-connaissances/
Disallow: /livres-blancs/
Disallow: /documentation/

User-agent: OAI-SearchBot
Allow: /
Dans cet exemple, les contenus qui construisent la connaissance de votre marque restent accessibles.
Les contenus qui concentrent votre valeur méthodologique restent protégés.
Personnellement, je trouve cette approche beaucoup plus intéressante qu’une règle identique appliquée à tout le domaine.
Pourquoi je conseille rarement de bloquer GPTBot
Dans les entreprises que j’accompagne, je retrouve souvent la même mécanique.
Quelqu’un découvre GPTBot.
Il pense : « OpenAI aspire nos contenus pour entraîner ses modèles ».
Et quelques minutes plus tard, le crawler se retrouve bloqué.
Je comprends parfaitement le réflexe.
Le bénéfice paraît immédiat : les prochaines publications restent hors de la collecte GPTBot.
Le coût, lui, se voit beaucoup moins.
Une marque peut perdre progressivement une partie de sa présence dans les données servant à construire les futures générations de modèles.
Et si l’hypothèse étudiée par Seer Interactive se confirme, cette absence intervient très tôt dans la mécanique : avant même la recherche de sources.
Le bénéfice arrive tout de suite, le coût beaucoup plus tard
C’est précisément ce décalage qui rend la décision difficile.
La protection du contenu se comprend immédiatement.
La perte éventuelle de familiarité avec la marque apparaît plusieurs mois ou plusieurs générations de modèles plus tard.
Et entre-temps, le petit réglage technique reste tranquillement dans le robots.txt.
Une décision de 2024 peut encore vivre en 2026
Voilà quelque chose que je vois régulièrement avec les réglages techniques.
On les ajoute.
Puis tout le monde les oublie.
Or l’écosystème a beaucoup évolué entre 2024 et 2026 : séparation entre robots d’entraînement et de recherche, apparition d’OAI-SearchBot, déploiement des Aperçus IA en France…
Le contexte change beaucoup plus vite que certains fichiers robots.txt.
Les médias possèdent une situation très particulière
Une grande partie du débat public vient des éditeurs de presse.
Et leur logique économique se tient : ils vendent précisément le contenu que les modèles souhaitent absorber.
Une marque de services fonctionne autrement.
Son article sert souvent à attirer un prospect, construire son expertise et faire connaître son activité.
Les deux entreprises publient du contenu. Leur intérêt face à GPTBot peut pourtant être totalement différent.
Ma nuance tient donc en une phrase : quand le contenu constitue directement votre produit, bloquer GPTBot peut avoir beaucoup de sens. Pour les autres modèles économiques, j’étudie d’abord le coût en visibilité.
📌 À compléter avec mon vécu : un client ayant rouvert GPTBot après analyse, ou un client pour lequel j’ai conseillé de maintenir le blocage en raison de la valeur directement substituable de ses contenus.
Comment je décide en vingt minutes
Quand un client me demande quoi faire, je commence rarement par son robots.txt.
Je commence par son business.
Et je déroule quatre questions.
1. Votre chiffre d’affaires dépend-il de la consultation de votre contenu ?
Un site média financé par l’audience possède un intérêt évident à protéger sa matière éditoriale. Une entreprise qui vend une prestation ou un produit utilise davantage son contenu comme outil d’acquisition.
- Publicité, abonnement ou audience monétisée : le blocage mérite une étude sérieuse
- Vente de produits ou de services : l’ouverture possède généralement davantage de valeur commerciale
2. Un tiers peut-il reconstituer votre proposition commerciale grâce à votre contenu ?
Je regarde ensuite le niveau de détail publié.
Votre documentation contient toute la méthode facturée à vos clients ? Je protège cette zone.
Votre blog explique surtout votre expertise et vos domaines d’intervention ? La logique change complètement.
3. Disposez-vous d’un véritable levier de négociation ?
Un éditeur couvert par les droits voisins ou une organisation dotée d’un poids sectoriel peut utiliser l’accès à ses contenus comme levier.
Une PME isolée se trouve dans une situation différente.
Son arbitrage porte davantage sur la protection éditoriale face à la visibilité future.
4. Qui rouvrira le dossier dans un an ?
Celle-ci paraît toute bête.
Pourtant, je la trouve déterminante.
Une règle placée dans le robots.txt aujourd’hui peut encore tourner plusieurs années plus tard. Je préfère donc ajouter immédiatement une date de révision.
# Politique robots IA — décidée le 04/09/2026 par [équipe]
# Entraînement autorisé : construction de marque prioritaire sur protection du contenu
# Zones exclues : documentation technique (valeur substituable)
# À revoir : septembre 2027
Ça prend deux minutes.
Et dans un an, la personne qui ouvre le fichier comprend immédiatement pourquoi cette décision existe.
Questions fréquentes
Je termine avec les questions qui reviennent le plus souvent quand j’évoque le fait de bloquer GPTBot.
Bloquer GPTBot me retire-t-il de ChatGPT ?
GPTBot concerne l’entraînement des futurs modèles. OAI-SearchBot gère la partie recherche.
Vous pouvez donc fermer GPTBot tout en conservant OAI-SearchBot ouvert.
La différence se situe surtout dans les réponses produites directement depuis les connaissances apprises par le modèle.
Le blocage agit-il sur les contenus déjà collectés ?
Le blocage agit sur les prochaines collectes.
Les contenus déjà intégrés à des modèles entraînés restent présents dans ces générations.
Une entreprise ouverte depuis plusieurs années protège donc surtout ce qu’elle publiera ensuite.
Puis-je autoriser GPTBot sur une partie du site seulement ?
Oui.
Le robots.txt accepte des directives par chemin. Vous pouvez ouvrir votre blog et vos pages marketing, puis fermer une base de connaissances, une documentation ou des livres blancs.
Pour beaucoup d’entreprises, cette configuration granulaire représente le compromis le plus intéressant.
Quelle configuration privilégier pour un éditeur de presse ?
Le couple blocage de GPTBot et ouverture d’OAI-SearchBot correspond bien à ce modèle économique.
L’éditeur limite l’utilisation de ses futurs contenus pour l’entraînement tout en conservant leur accessibilité dans la recherche ChatGPT.
Le cadre français des droits voisins ajoute aussi une dimension économique à cette décision.
Comment vérifier ce que fait mon robots.txt aujourd’hui ?
Je commence par ouvrir votresite.fr/robots.txt.
Je cherche ensuite chaque user-agent concerné ainsi que les éventuelles règles User-agent: *.
Puis je regarde les logs serveur. Un pare-feu peut aussi bloquer un crawler même avec un robots.txt ouvert.
Et ça, c’est typiquement le genre de détail qui peut faire perdre beaucoup de temps lors d’un diagnostic.
À quelle fréquence revoir cette décision ?
Une fois par an me paraît être un bon rythme minimum.
L’écosystème évolue très vite. Entre 2024 et 2026, OpenAI a séparé plusieurs usages entre ses robots, OAI-SearchBot a pris une place spécifique et les Aperçus IA sont arrivés en France.
Votre politique de crawlers mérite donc une date, un motif et une échéance de révision.
Sources
Voici les documents et analyses utilisés dans cet article.
- OpenAI, Overview of OpenAI Crawlers, documentation développeurs
- Seer Interactive, What Drives Brand Mentions in AI Answers?, octobre 2025, plus de 360 000 réponses
- Blog du Modérateur, Google déploie AI Overviews et AI Mode en France, 22 juillet 2026
- Ahrefs, Top Brand Visibility Factors in ChatGPT, AI Mode, and AI Overviews, 75 000 marques