
Mon entreprise est invisible dans ChatGPT.
Bon. Dit comme ça, le constat fait un peu mal.
Et la réaction arrive vite : retravailler les contenus, publier davantage, ajouter du schema, chercher des backlinks, revoir tout le site… J’ai déjà vu ce scénario. Plusieurs fois.
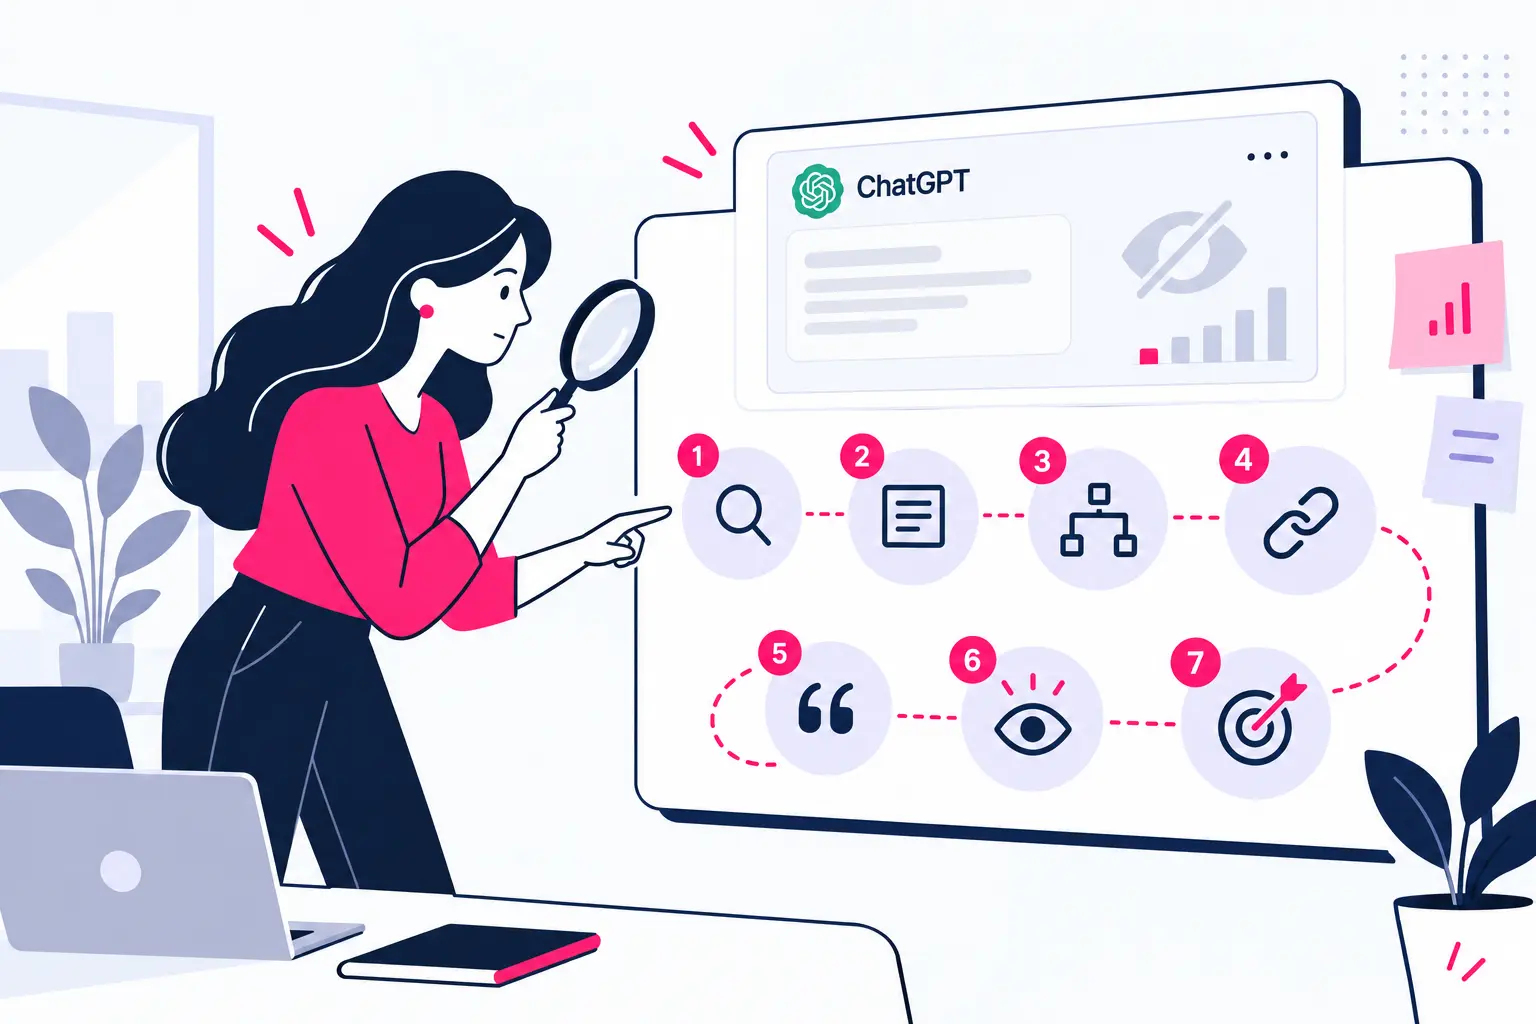
Sauf qu’avant de toucher à quoi que ce soit, je vérifie toujours sept points très précis : accès du crawler, réponse du serveur, rendu du contenu, extractibilité des passages, résolution de l’entité, présence hors-site et niveau de concurrence sur la catégorie.
Pourquoi cet ordre ? Parce que les trois premières étapes sont presque binaires. Le crawler entre ou il reste dehors. Le serveur répond correctement ou il renvoie une erreur. Le contenu apparaît dans le HTML reçu ou il reste dépendant du JavaScript.
Et là, surprise : certains problèmes se règlent en quelques heures.
Les étapes suivantes, elles, demandent davantage de temps. Plusieurs semaines. Parfois plusieurs mois.
Alors, avant de lancer six mois de stratégie éditoriale, je préfère vérifier qu’un 429 ne bloque déjà toute la mécanique dans les logs.
Par Alexandre Montenon, consultant GEO à Lyon
Avant tout : êtes-vous vraiment invisible dans ChatGPT ?
Première question. Et elle paraît presque trop simple.
Ma marque est-elle réellement invisible ?
Parce qu’une réponse générative change d’une exécution à l’autre. Je peux lancer exactement le même prompt deux fois et obtenir deux formulations différentes, des sources différentes et parfois des marques différentes.
Du coup, un test unique m’intéresse assez peu.
Pour mesurer une vraie situation d’invisibilité dans ChatGPT, j’utilise au minimum :
- cinq à dix prompts représentatifs du marché, rédigés une fois puis conservés
- une session propre en navigation privée, avec mémoire désactivée, compte déconnecté et localisation française
- trois exécutions minimum pour chaque prompt
Dix prompts. Trois exécutions. J’arrive à trente réponses.
Et là, je commence à avoir quelque chose d’exploitable.
Une marque absente des trente réponses présente un vrai sujet de visibilité. Une marque présente quatre fois sur trente raconte déjà une autre histoire : elle existe dans l’écosystème, mais sa part de mentions reste faible.
Ce détail change complètement la suite du diagnostic.
Je regarde ensuite une deuxième chose : qu’est-ce qui disparaît exactement ?
La marque peut être absente du texte généré. Les pages du site peuvent aussi disparaître des sources citées. À première vue, ça ressemble au même problème. Techniquement, ce sont deux sujets différents.
Les étapes 1 à 4 concernent surtout l’absence des sources. Les étapes 5 à 7 concernent surtout l’absence des mentions.
Invisible dans ChatGPT : le diagnostic en un coup d’œil
J’utilise toujours le même ordre. Il m’évite de partir directement sur des actions longues alors qu’un blocage technique se trouve parfois tout en haut de la pile.
| # | Vérification | Nature | Délai de correction |
|---|---|---|---|
| 1 | OAI-SearchBot autorisé | Binaire | Heures |
| 2 | Serveur qui répond 200 aux crawlers IA | Binaire | Heures à jours |
| 3 | Contenu présent sans JavaScript | Binaire | Jours à semaines |
| 4 | Passages extractibles | Graduel | Semaines |
| 5 | Entité résolue | Graduel | 3 à 9 mois |
| 6 | Mentions hors-site | Graduel | 6 à 12 mois |
| 7 | Catégorie disponible | Stratégique | Arbitrage |
Je garde vraiment cet ordre. Chaque étape conditionne la suivante.
Réécrire une page inaccessible au crawler ? L’effort éditorial reste bloqué derrière la porte.
Étape 1. Le crawler peut-il accéder à vos pages ?
Je commence donc par la porte d’entrée.
OAI-SearchBot peut-il accéder au site ?
La documentation d’OpenAI indique qu’un site bloquant OAI-SearchBot sort des réponses issues de la recherche ChatGPT. Là, je ne cherche même encore à analyser la qualité du contenu. Je vérifie simplement l’accès.
J’ouvre votresite.fr/robots.txt.
Et je cherche une directive Disallow visant OAI-SearchBot, ou un User-agent: * suffisamment restrictif pour lui fermer l’accès.
Simple ? Oui. Et pourtant, une confusion revient souvent.
OpenAI utilise plusieurs robots. Et ils ne servent pas tous à la même chose :
GPTBotconcerne l’entraînementChatGPT-Userintervient lors d’une récupération demandée par un utilisateurOAI-SearchBotconcerne la recherche
En 2024, beaucoup d’entreprises ont choisi de bloquer les robots IA en bloc. Sur le principe, je comprends très bien la logique : protéger les contenus.
Sauf qu’en fermant la porte à tout le monde, certaines ont également fermé celle qui permettait à leurs pages de remonter dans la recherche ChatGPT.
La correction consiste à autoriser explicitement OAI-SearchBot. Je compte ensuite environ 24 heures de propagation.
Et tant que je suis dans le fichier, j’en profite pour regarder aussi Claude-SearchBot, PerplexityBot et Googlebot.
Étape 2. Votre serveur leur répond-il correctement ?
Le robots.txt est propre.
Très bien.
Est-ce que cela signifie que le crawler accède réellement au site ? Là, ça devient plus intéressant.
Parce qu’entre le fichier robots.txt et la page se trouvent parfois un CDN, un pare-feu applicatif, une protection anti-bots ou une limitation de débit particulièrement enthousiaste.
Et eux peuvent très bien répondre 403 ou 429.
Du point de vue du crawler, le message est assez simple : accès refusé.
Je vais donc regarder les logs :
grep -E "OAI-SearchBot|GPTBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log \
  | awk '{print $9}' | sort | uniq -c | sort -rn
Ce que je veux voir ? Une très large majorité de codes 200.
Si les 403 et les 429 commencent à prendre de la place, je sais où chercher.
Et si la commande ne remonte aucune ligne ? Là aussi, je creuse. Soit les bots fréquentent très peu le site, soit les logs se trouvent ailleurs ou utilisent une autre configuration.
Je cherche ensuite la règle responsable : bot fight mode, limitation par user-agent, challenge JavaScript sur des pages publiques…
Pour les exceptions, je préfère utiliser les plages d’IP officielles publiées par les plateformes. Un user-agent se copie beaucoup trop facilement pour devenir une preuve fiable à lui seul.
Dernier détail que j’ai appris à surveiller : les règles de sécurité reviennent parfois après une maintenance.
Donc oui, je remets ce contrôle dans ma routine trimestrielle.
Étape 3. Votre contenu est-il visible sans JavaScript ?
Le crawler entre. Le serveur lui répond correctement.
Très bien.
Maintenant, que voit-il réellement ?
Parce qu’un site peut sembler parfaitement normal dans mon navigateur tout en envoyant un HTML presque vide avant l’exécution du JavaScript.
Googlebot sait gérer énormément de choses côté rendu. Les crawlers IA disposent encore de capacités plus variables.
Alors je fais un test très basique :
curl -sL -A "OAI-SearchBot" https://votresite.fr/page | grep -i "votre phrase de réponse"Je cherche une phrase précise de la page.
Elle remonte ? Très bien.
Elle reste absente ? Le crawler reçoit une version du document qui ne contient probablement pas ce passage.
À ce stade, je regarde le rendu côté serveur ou la génération statique des pages stratégiques.
Et là, oui, le chantier peut devenir plus conséquent. Sur certains frameworks JavaScript, cette étape demande davantage qu’une petite modification SEO dans WordPress.
Étape 4. Vos pages produisent-elles un passage citable ?
Voilà. Techniquement, le crawler entre, le serveur répond et le texte est visible.
Je pourrais croire que le plus dur est fait.
Pas tout à fait.
Une IA ne récupère pas nécessairement une page entière avant de décider de la citer. La récupération fonctionne beaucoup au niveau du passage.
Et c’est là qu’une page pourtant excellente pour un lecteur humain peut devenir beaucoup moins pratique pour un moteur génératif.
Je prends une section. Je l’isole complètement. Puis je me pose trois questions :
- répond-elle directement à une question ?
- nomme-t-elle clairement l’entité concernée ?
- reste-t-elle compréhensible toute seule ?
Une section qui commence par « comme vu plus haut » part déjà avec un handicap.
Une réponse qui arrive après quatre paragraphes de contexte aussi.
Et un H2 qui tente de répondre à trois questions différentes ? Là, je découpe.
| Symptôme | Correction |
|---|---|
| La réponse arrive en fin de section | Réponse dans les 40 à 60 premiers mots |
| « Comme vu plus haut », « cette méthode » | Nommer l’entité dans le bloc |
| Un titre couvre trois questions | Un titre, une question |
| Uniquement du qualitatif | Ajouter des données sourcées et datées |
| Date absente du HTML rendu | Afficher publication et mise à jour |
Les données disponibles confortent cette logique. L’ajout de citations verbatim issues de sources crédibles améliore la visibilité jusqu’à 40 %, tandis que l’ajout de statistiques atteint environ 30 à 35 %.
À l’inverse, le bourrage de mots-clés fait reculer la visibilité d’environ 10 % sur Perplexity.
Autrement dit : répéter quinze fois le mot-clé n’a rien d’une stratégie GEO très sophistiquée.
La fraîcheur entre aussi dans l’équation : 65 % des visites de bots IA ciblent du contenu publié dans l’année, d’après Seer Interactive.
Après une réécriture et un nouveau passage du crawler, j’attends généralement quelques semaines avant de tirer une conclusion.
Étape 5. Votre entité est-elle résolue ?
À ce stade, je change complètement de focale.
Je quitte la page.
Et je regarde l’entreprise.
Parce qu’un modèle manipule aussi des entités : entreprises, marques, personnes, produits, lieux… avec leurs attributs et les relations qui les relient.
Si le nom de l’entreprise ressemble à celui d’une autre société, que LinkedIn raconte une chose, le site une autre et les plateformes tierces encore autre chose, la compréhension devient beaucoup moins nette.
Mon petit test maison ?
Je demande directement à ChatGPT : « Que fais-tu de l’entreprise X ? »
Et je regarde ce qui revient.
- l’activité est décrite correctement : l’entité semble résolue
- l’entreprise est confondue avec une autre organisation : je travaille la désambiguïsation
- ChatGPT connaît très peu l’entreprise : je passe à l’étape suivante
Pour renforcer cette entité, je commence par ce qui me paraît le plus logique :
- une page canonique exhaustive présentant l’organisation, son activité, son histoire et ses dirigeants
- un bloc
Organizationen JSON-LD avec unsameAsreliant LinkedIn, YouTube, plateformes d’avis et Wikidata - une fiche Wikidata avec des propriétés structurées lisibles par machine
- une cohérence stricte du nom, de la description et de la catégorie sur toutes les propriétés
Et là, je change d’échelle de temps. Je situe ce chantier entre trois et neuf mois.
Étape 6. Existez-vous ailleurs que sur votre site ?
Voilà probablement l’étape qui surprend le plus.
Une marque peut avoir un très beau site, publier régulièrement, travailler ses données structurées et rester malgré tout invisible dans ChatGPT.
Pourquoi ? Parce qu’elle existe surtout… chez elle.
Muck Rack relève que 82 % des liens cités par l’IA proviennent d’earned media et que 94 % viennent de sources externes aux propriétés détenues ou payées par la marque.
Ça change complètement ma manière de regarder la visibilité IA.
Je relève donc les domaines que ChatGPT cite sur les prompts suivis. Ensuite, je compare cette liste aux endroits où la marque apparaît réellement.
Et généralement, l’écart me raconte déjà beaucoup de choses.
L’analyse réalisée sur 75 000 marques fait ressortir plusieurs leviers avec des niveaux de corrélation très différents :
- YouTube affiche une corrélation d’environ 0,737, la plus élevée de l’analyse, y compris sur ChatGPT. Le volume de mentions compte légèrement davantage que l’audience et le nom de la marque gagne à être prononcé dans la vidéo
- les mentions web de marque atteignent environ 0,664, très loin devant les backlinks autour de 0,218
- les plateformes d’avis actives augmentent la probabilité de citation dans toutes les verticales étudiées sur 800 000 réponses analysées par Seer Interactive et Trustpilot
- les relations presse demandent aussi une autre lecture : Muck Rack relève seulement 2 % de recouvrement entre les journalistes les plus sollicités par les équipes RP et ceux réellement cités par l’IA
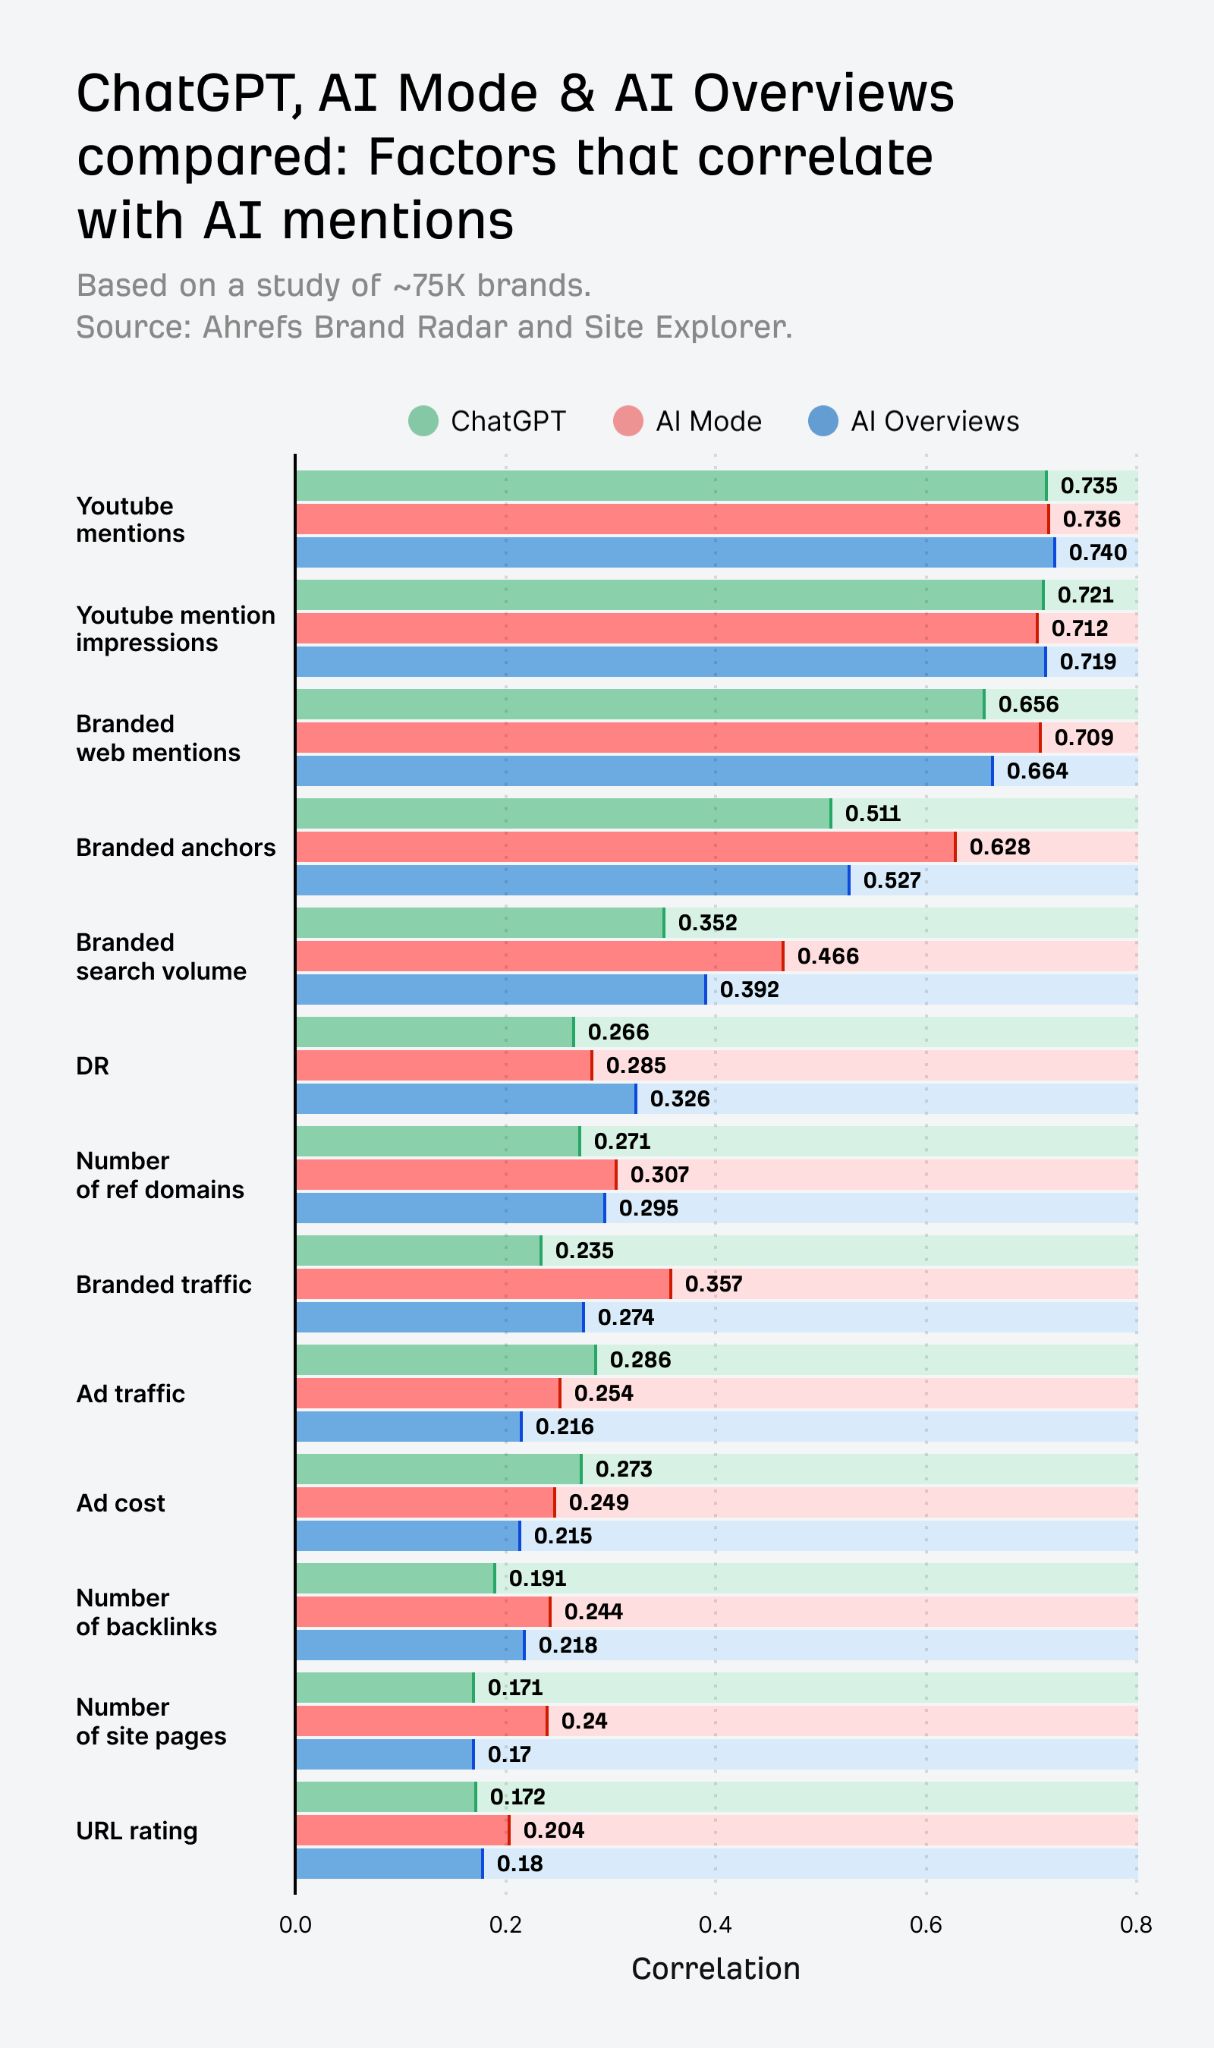
Le graphique rend la différence assez spectaculaire. Sur ChatGPT, les mentions YouTube atteignent 0,735 et les mentions web de marque 0,656. Le nombre de backlinks descend à 0,191.
Oui, ça bouscule un peu les vieux réflexes SEO.
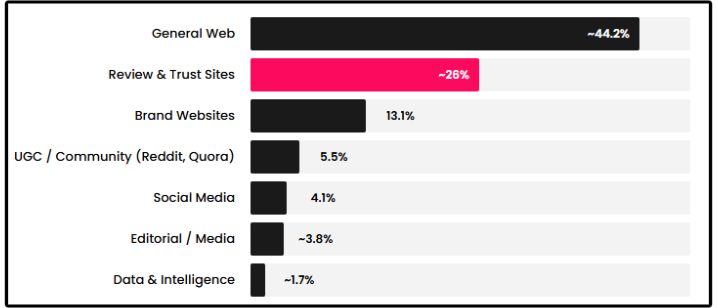
Ce deuxième visuel explique aussi pourquoi je surveille autant les plateformes tierces. Les sites d’avis et de confiance apparaissent régulièrement dans les sources utilisées, aux côtés du web général et des sites de marque.
Et publier encore vingt pages sur le site ? La corrélation entre le nombre de pages et la visibilité IA tourne autour de 0,194.
Je préfère donc travailler la présence hors-site sur un horizon de six à douze mois.
Étape 7. La catégorie est-elle déjà prise ?
Dernière étape.
Et parfois, le site fonctionne très bien. L’entité aussi. Les mentions existent.
Le problème se trouve ailleurs : quelqu’un occupe déjà énormément le terrain.
Alors je prends cinq prompts de catégorie.
La même marque revient quatre fois ou davantage, avec une avance nette ? Je considère qu’un acteur domine déjà fortement cette catégorie.
Ça semble décourageant.
Et pourtant, les chiffres racontent aussi quelque chose d’assez intéressant : 15,2 % seulement des catégories étudiées avaient un propriétaire clair. Et 53,7 % ne présentaient aucune marque récurrente.
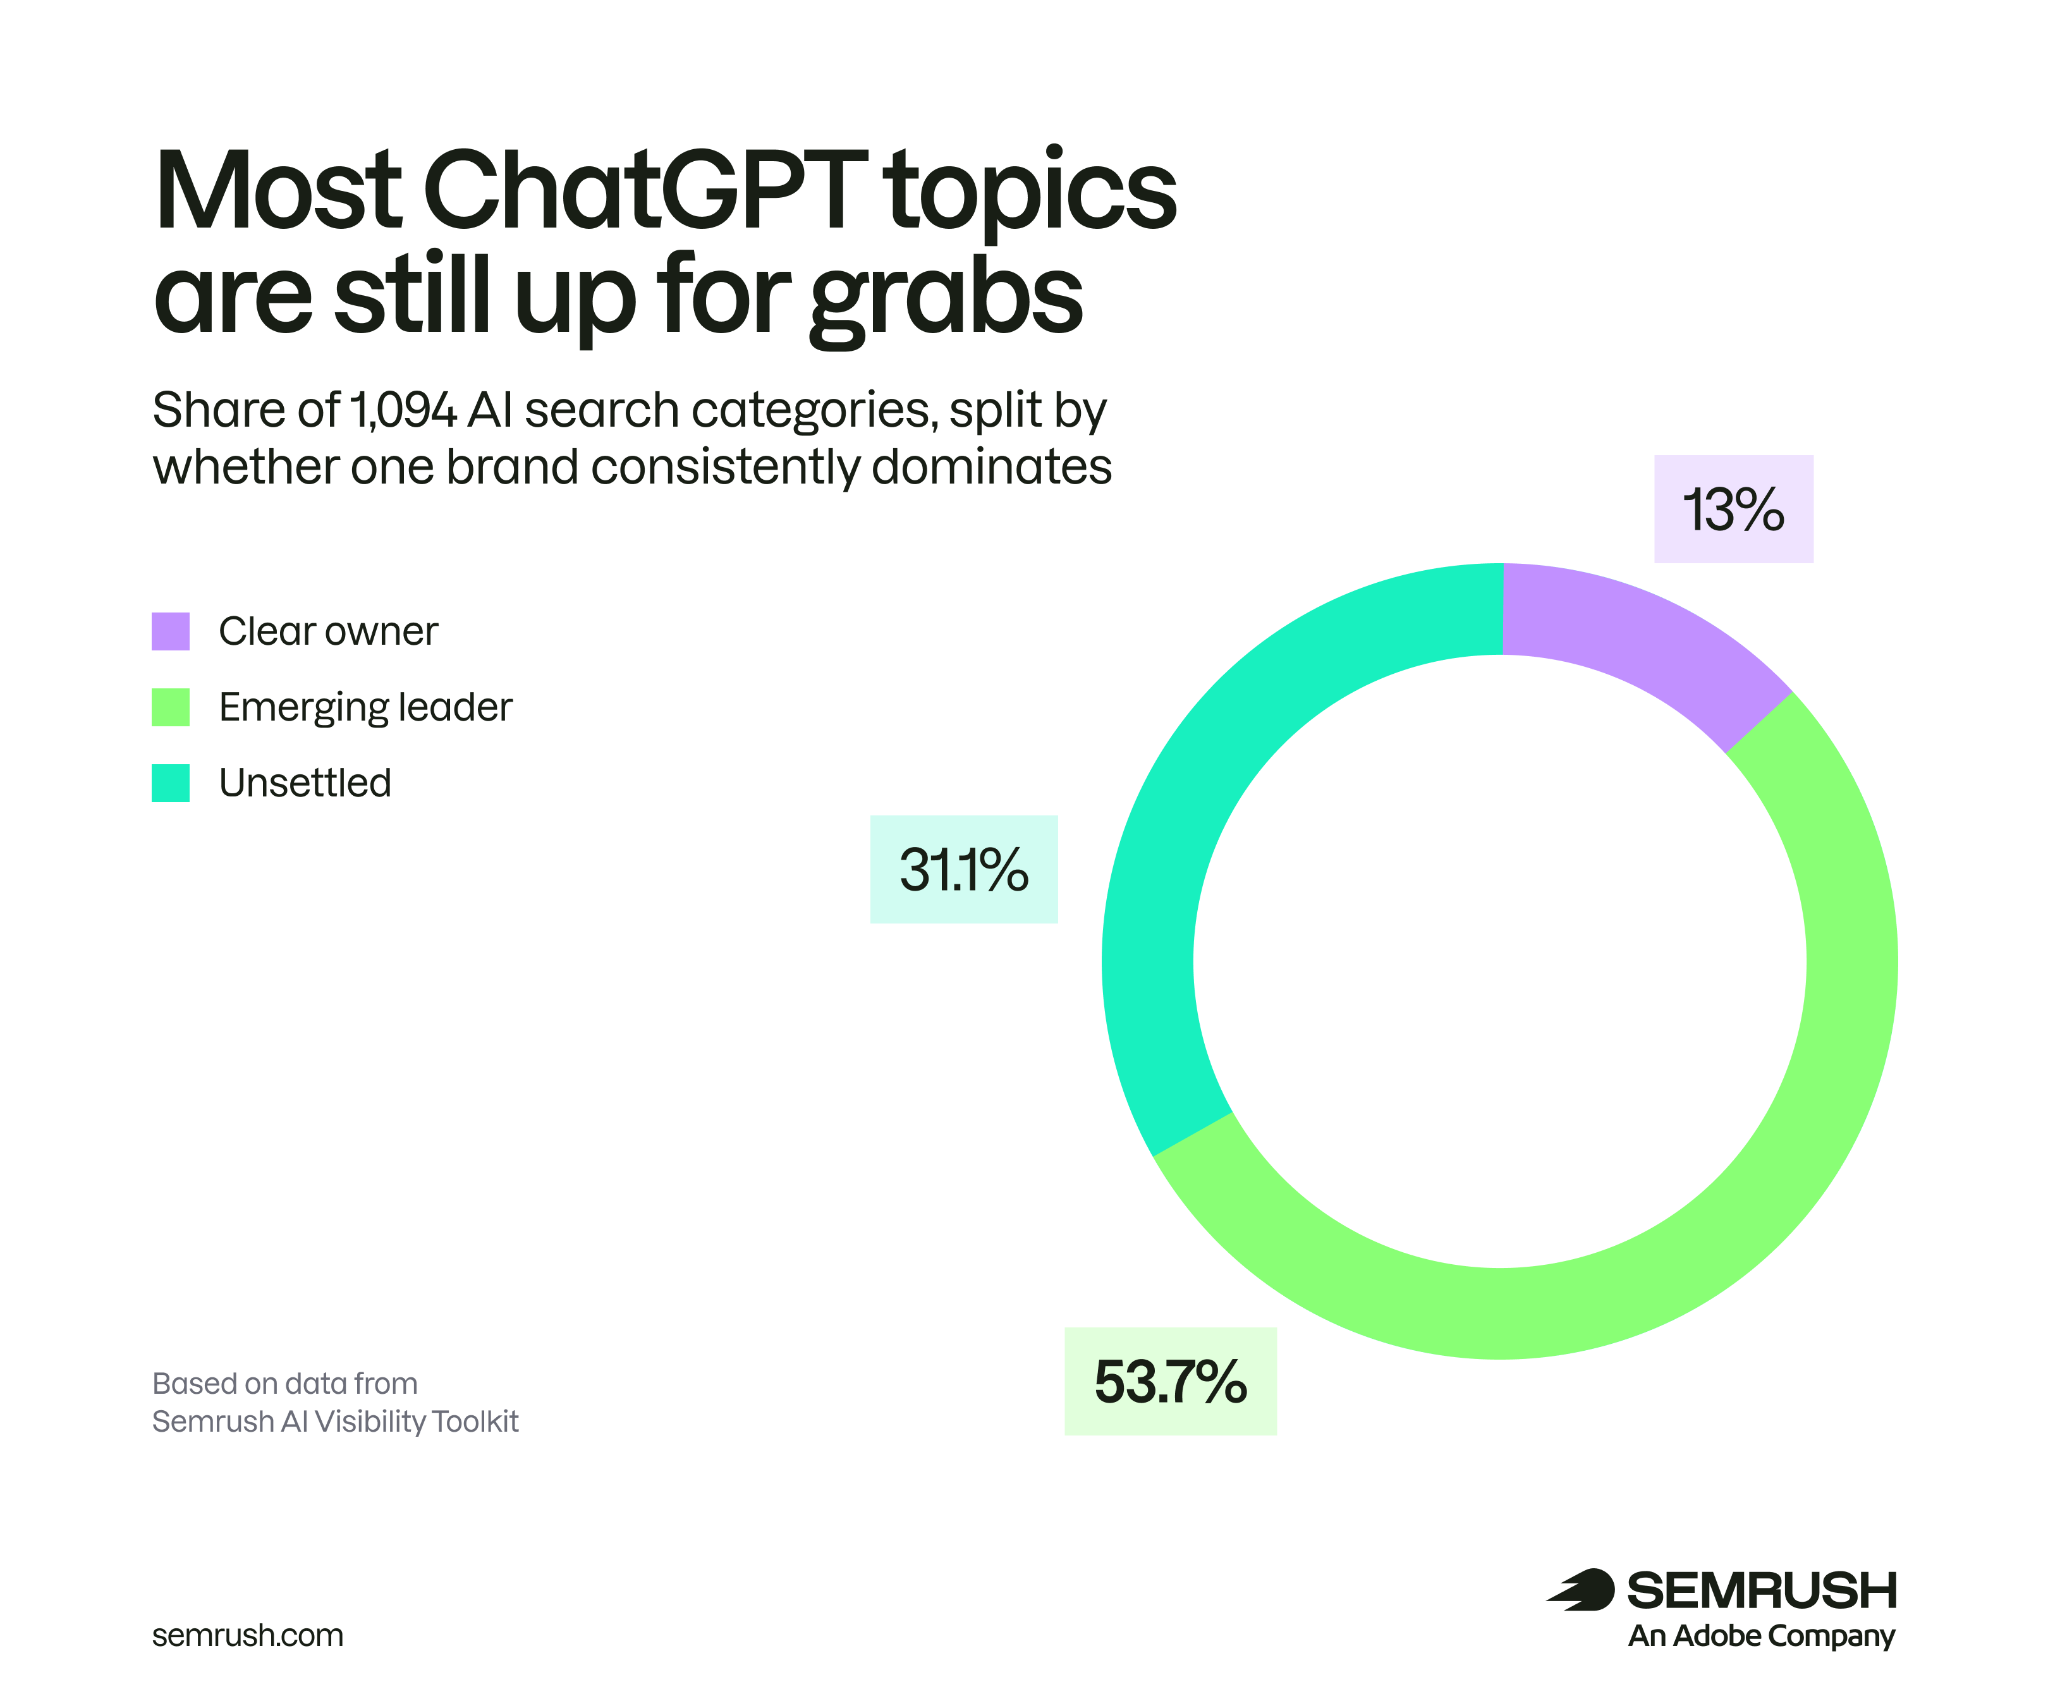
Autre détail que je trouve assez contre-intuitif : les sujets à forte demande sont moins souvent dominés, avec 11,3 %, contre 19 % pour les niches.
Face à une catégorie déjà très occupée, je regarde donc les catégories adjacentes où l’entreprise reste légitime et où la concurrence se montre plus ouverte.
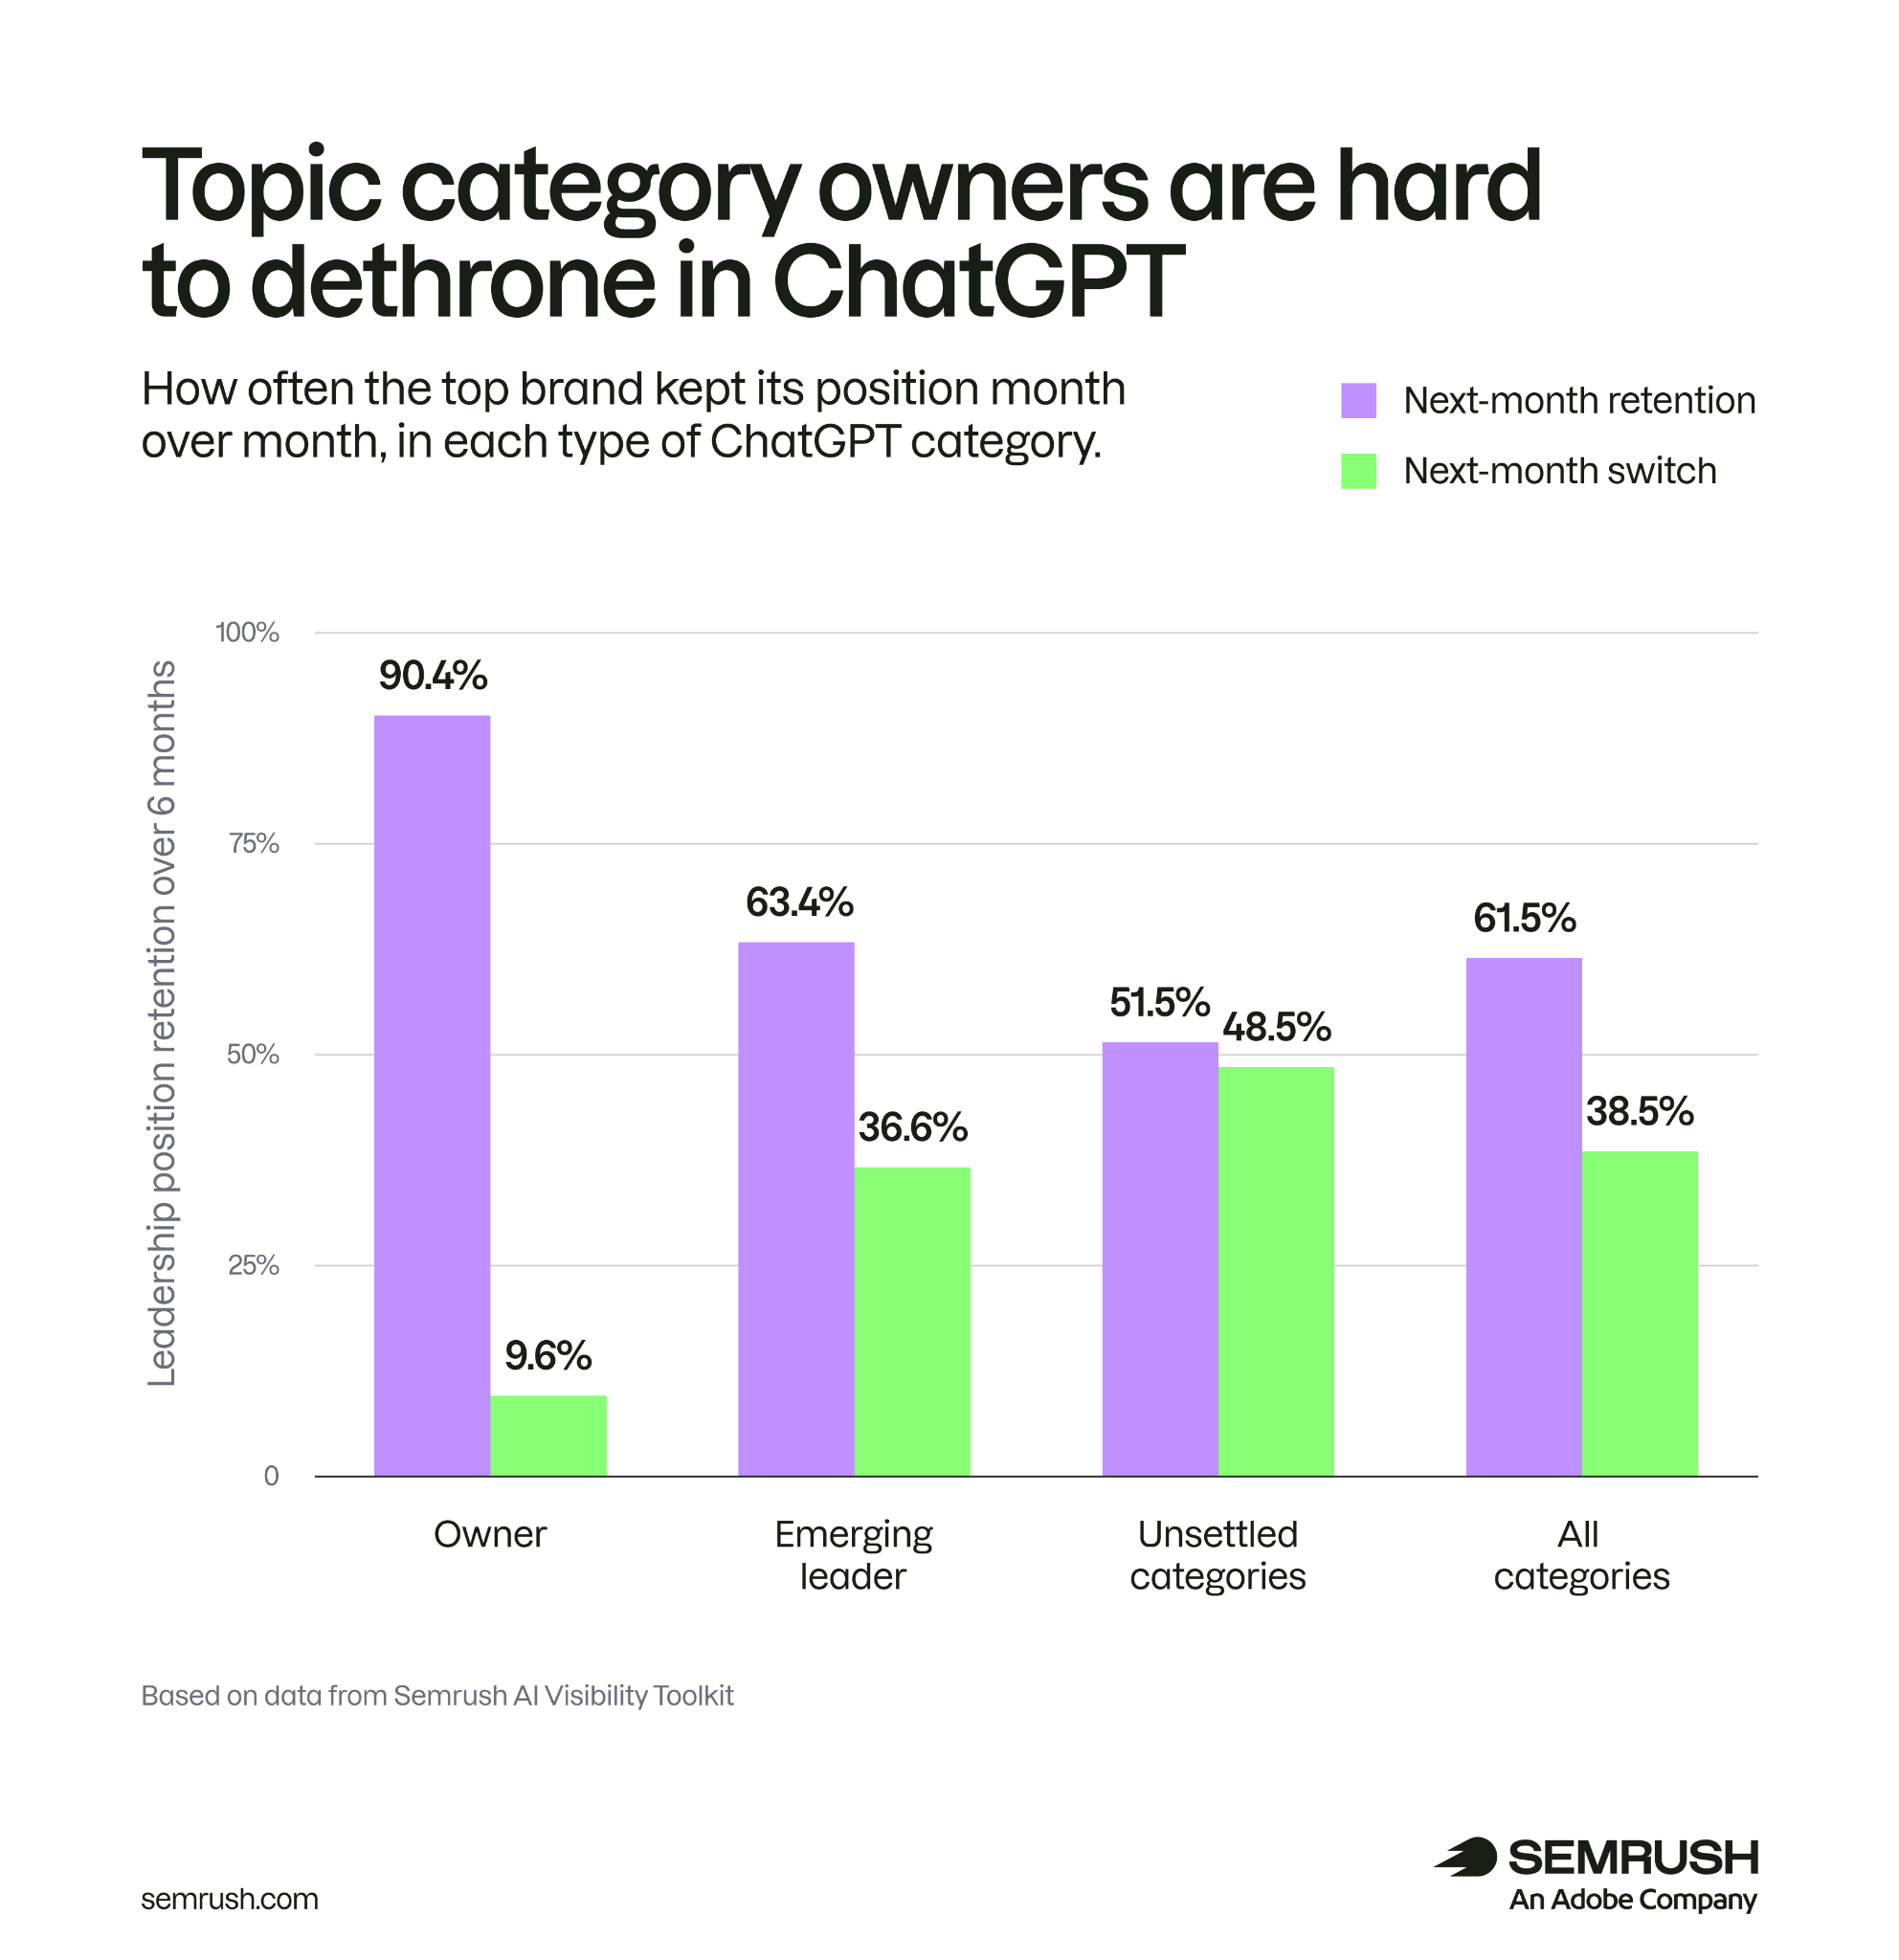
Et surtout, je préfère devenir vraiment visible sur quelques catégories cohérentes plutôt que vaguement présent partout.
Les petites avances bougent beaucoup. Les écarts nets tiennent davantage dans le temps.
Questions fréquentes
Le diagnostic soulève souvent les mêmes questions. Je les regroupe ici, avec les délais et les points techniques à garder en tête.
Combien de temps faut-il pour réapparaître après correction ?
Pour un problème d’accès, je compte quelques jours : environ 24 heures de propagation côté OpenAI, auxquelles s’ajoute le délai du prochain passage du crawler. Une réécriture demande plutôt quelques semaines. La résolution d’entité se situe entre trois et neuf mois. Les mentions hors-site demandent généralement six à douze mois.
Comment savoir si mon pare-feu bloque les crawlers IA ?
Je filtre les logs avec les user-agents des bots IA et j’examine les codes de réponse. Une proportion notable de 403 ou de 429 m’oriente vers le pare-feu applicatif ou la limitation de débit. Une absence totale de lignes mérite également une vérification.
Ma marque apparaît parfois, parfois moins souvent : est-ce un problème ?
Les réponses génératives varient entre deux exécutions. Je regarde donc surtout la part de réponses dans lesquelles la marque apparaît, sur plusieurs prompts et plusieurs exécutions.
Faut-il corriger toutes les étapes en même temps ?
Je commence par les trois premières. Elles constituent les prérequis techniques. Ensuite, j’avance étape par étape en mesurant les évolutions. Sinon, impossible de savoir quelle action a réellement changé quelque chose.
Mon site est bien classé sur Google mais invisible dans ChatGPT : est-ce normal ?
Oui. La page citée par ChatGPT se situe en position 21 ou au-delà sur Google dans près de 90 % des cas étudiés. Le classement Google et la citation dans ChatGPT reposent donc sur des mécanismes largement distincts.
Un beau top 3 Google reste agréable à regarder. Il ne suffit simplement plus à raconter toute l’histoire.
Puis-je faire ce diagnostic seul ?
Les étapes 1 à 3 demandent surtout un accès aux logs et au fichier robots.txt. Un développeur peut généralement les traiter assez vite. L’étape 4 concerne davantage la rédaction et la structuration. Les étapes 5 à 7 deviennent de vrais chantiers de visibilité, avec davantage de temps et de budget.
Moi, je commence toujours par le début. Parce qu’avant de chercher